В robots.txt для ИИ-ботов правила задаются для каждого бота отдельно: общего переключателя «ИИ» там нет. Чтобы попадать в ответы ChatGPT, Claude и Perplexity, откройте доступ поисковым краулерам (OAI-SearchBot, Claude-SearchBot, PerplexityBot) и ботам, которые заходят на страницу по запросу пользователя (ChatGPT-User, Claude-User, Perplexity-User). Закрывать ли обучающих краулеров и токены вроде GPTBot, ClaudeBot, Google-Extended и Applebot-Extended — отдельное решение. OpenAI прямо пишет, что настройки для каждого её краулера не зависят друг от друга.
Robots.txt — обычный текстовый файл в корне сайта (вашсайт.kz/robots.txt). Он сообщает краулерам, какие страницы им можно загружать. 2 ноября 2026 года Адам Фрай, который руководит потребительским направлением ChatGPT, заявил, что объём поисковых запросов в ChatGPT составляет примерно пятую часть от Google. К этой цифре стоит относиться осторожно. По данным прессы, OpenAI считает поиском случай, когда вопрос пользователя запускает веб-поиск, а абсолютных чисел Фрай не привёл. В обзоре MarketingProfs AI Update также отметили, что OpenAI не назвала источник данных для сравнения с Google.
Какой бы ни была точная доля, ChatGPT сможет показать ваши страницы в таких ответах, только если до них доберётся его поисковый краулер. Это руководство — именно про этот технический шаг: как сделать так, чтобы нужные боты могли зайти на сайт.
Почему сайты закрываются от ИИ-ботов, сами того не зная?
Часто блокировку ChatGPT или Claude никто сознательно не включал. Её создаёт настройка по умолчанию, правило, скопированное с другого сайта, или защитный инструмент. Начните с проверки четырёх причин.
Переключатели «блокировать ИИ-ботов» в CDN и на хостинге
CDN (сеть доставки контента) — сервис, который стоит между вашим сервером и посетителями: ускоряет сайт и фильтрует трафик. 1 июля 2025 года Cloudflare объявила, что по умолчанию блокирует известных ИИ-краулеров на новых доменах. Владелец может разрешить им доступ, а ещё Cloudflare предлагает управляемый robots.txt.
Если домен подключили к Cloudflare после этой даты или кто-то включил опцию «блокировать ИИ», боты могут получать отказ ещё до того, как увидят ваш robots.txt. Откройте эту настройку и посмотрите, каких ботов она касается. Общий переключатель «ИИ-боты» может задевать не только обучающих, но и поисковых краулеров. Поищите похожие опции в панели хостинга и в других CDN, если вы ими пользуетесь.
Скопированные правила и сплошной Disallow
На некоторых сайтах до сих пор стоит User-agent: * и под ним Disallow: /. Обычно это остаётся после тестовой версии сайта или редизайна. Такая запись просит не заходить всех краулеров, которые соблюдают robots.txt, в том числе поисковых ИИ-ботов. Другие сайты вставляют длинный список «заблокировать весь ИИ» из какой-нибудь статьи и не проверяют, какие боты в нём перечислены.
Правила файрвола, которые отвечают ботам ошибкой 403 или проверкой
WAF (файрвол веб-приложений) отсекает трафик, похожий на автоматический. Режимы борьбы с ботами, лимиты на частоту запросов и блокировки по странам могут отдавать ИИ-ботам ответ 403 (доступ запрещён), 429 (слишком много запросов) или страницу с CAPTCHA. В robots.txt может стоять «разрешить», а бот всё равно не получит ничего, что можно прочитать.
Устаревшие имена ботов
В старых списках правил часто встречаются anthropic-ai или Claude-Web — токены, которые Anthropic использовала до ClaudeBot. В актуальной документации Anthropic описывает три других бота: ClaudeBot, Claude-User и Claude-SearchBot. Файл, где указаны только старые токены, на текущих ботов не действует. Вы можете думать, что отказались от обучения, хотя на деле это не так.
Каких ИИ-краулеров можно закрыть и чем придётся заплатить?
У OpenAI и Anthropic есть отдельные боты для обучения, для поискового индекса и для загрузки страницы по запросу пользователя. У Perplexity — поисковый краулер и бот для запросов пользователя. Google и Apple вместо отдельных обучающих краулеров используют токены для отказа.
Обучающие краулеры и токены: GPTBot, ClaudeBot, Google-Extended, Applebot-Extended
Они определяют, можно ли использовать ваш контент для обучения будущих моделей. Появитесь ли вы в поисковых ответах ChatGPT, Claude или Perplexity, от них не зависит. Google-Extended стоит рассмотреть внимательнее: он касается ещё и граундинга в приложениях Gemini.
- GPTBot (OpenAI): запретив его, вы сообщаете, что ваш контент не следует использовать для обучения базовых моделей OpenAI.
- ClaudeBot (Anthropic): ограничив его, вы даёте сигнал исключить будущие материалы сайта из обучающих наборов данных.
- Google-Extended — это токен в robots.txt, а не отдельный краулер. Он определяет, можно ли использовать собранный Google контент для обучения Gemini и граундинга в приложениях Gemini. Граундинг — это когда модель в момент ответа получает свежий контент из интернета. На попадание в Google Поиск и позиции в нём Google-Extended не влияет.
- Applebot-Extended тоже не обходит страницы. Он сообщает Apple, можно ли использовать данные, собранные Applebot, для обучения базовых моделей Apple. Siri и Spotlight по-прежнему используют Applebot.
Поисковые краулеры: OAI-SearchBot, Claude-SearchBot, PerplexityBot
Эти боты собирают индекс, по которому ИИ-ассистенты ищут информацию для ответов. Если их закрыть, вы потеряете больше всего и сразу. OpenAI пишет, что сайты, закрытые от OAI-SearchBot, «не будут показываться в ответах поиска ChatGPT», хотя могут появляться в виде навигационных ссылок. Anthropic предупреждает, что отключение Claude-SearchBot может снизить видимость и точность сайта в результатах поиска для пользователей. Perplexity описывает PerplexityBot как бота, который находит сайты и ставит на них ссылки в результатах поиска, и уточняет, что он не используется для обучения базовых моделей.
Боты по запросу пользователя: ChatGPT-User, Claude-User, Perplexity-User
Эти боты заходят на страницу, когда об этом просит человек. Условный пример: клиент из Алматы вставляет в ChatGPT ссылку на вашу страницу с ценами и просит коротко пересказать условия. OpenAI пишет, что ChatGPT-User не используется для автоматического обхода. Поскольку такие запросы запускает пользователь, «правила robots.txt могут не применяться». Perplexity сообщает, что Perplexity-User по той же причине как правило, игнорирует robots.txt. Anthropic же пишет, что её боты соблюдают robots.txt, а отключение Claude-User «может снизить видимость сайта при поиске по запросу пользователя».
Получается, что ботов OpenAI и Perplexity, которые заходят по запросу пользователя, robots.txt может вообще не остановить. Если они всё равно не могут прочитать ваши страницы, первым делом проверьте правила файрвола и CDN.
Список ИИ-ботов: чей бот, зачем он нужен, чем грозит блокировка и какое правило поставить
Правила в последнем столбце рассчитаны на самый частый выбор: не участвовать в обучении, но появляться в ответах ИИ. Если вы не против, чтобы ваш контент использовали для обучения, разрешите доступ всем.
| Бот / токен | Владелец | Задача | Что вы теряете при блокировке | Рекомендуемое правило |
|---|---|---|---|---|
| GPTBot | OpenAI | Собирает контент для обучения моделей | Ничего в поиске ChatGPT: это отказ от обучения | Disallow (если отказываетесь от обучения) |
| OAI-SearchBot | OpenAI | Индексирует сайты для поиска ChatGPT | Сайт не показывается в ответах поиска ChatGPT | Allow |
| ChatGPT-User | OpenAI | Загружает страницу по запросу пользователя | ChatGPT не может открыть вашу страницу для пользователя | Allow; не блокируйте в файрволе |
| OAI-AdsBot | OpenAI | Проверяет посадочные страницы рекламы в ChatGPT на соответствие правилам; по словам OpenAI, его данные не используются для обучения | OpenAI не может проверить ваши рекламные посадочные страницы | Allow, если вы рекламируетесь в ChatGPT |
| ClaudeBot | Anthropic | Собирает контент для обучения моделей | Ваш будущий контент исключается из обучающих наборов | Disallow (если отказываетесь от обучения) |
| Claude-SearchBot | Anthropic | Индексирует сайты для поиска Claude | Ниже видимость и точность в результатах поиска Claude | Allow |
| Claude-User | Anthropic | Загружает страницу по запросу пользователя | Ниже видимость при поиске по запросу пользователя | Allow |
| PerplexityBot | Perplexity | Находит сайты и ставит на них ссылки в поиске Perplexity | Поисковый краулер не находит ваш сайт и не ставит на него ссылки | Allow |
| Perplexity-User | Perplexity | Загружает страницу по запросу пользователя | Perplexity не может прочитать вашу страницу для пользователя | Allow; не блокируйте в файрволе |
| Google-Extended | Токен: обучение Gemini и граундинг в приложениях Gemini | Контент не используется для обучения и граундинга Gemini; на Google Поиск не влияет | На ваше усмотрение: Disallow, чтобы отказаться от обучения, Allow, если граундинг в Gemini важнее | |
| Applebot-Extended | Apple | Токен: обучение моделей Apple | На Siri и Spotlight не влияет | Disallow (если отказываетесь от обучения) |
Googlebot и Bingbot в таблицу не попали, потому что у них нет отдельного ИИ-токена, который бы их заменял. Обзоры от ИИ (AI Overviews) и режим ИИ (AI Mode) в Google работают через Googlebot и обычные настройки Поиска, а не через Google-Extended. У Microsoft нет отдельного токена для обучения ИИ. Для Bing Chat (теперь Copilot) Microsoft предлагает метатеги NOCACHE и NOARCHIVE, которые ограничивают использование вашего контента в ответах чата. Если закрыть Googlebot или Bingbot, вы потеряете гораздо больше, чем ответы ИИ.
Шаблон robots.txt для ИИ-ботов: без обучения, но с ответами
Скопируйте шаблон и замените закрытые разделы и адрес карты сайта на свои. Несколько строк User-agent могут относиться к одной группе правил.
# Поисковые ИИ-краулеры: разрешаем
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Allow: /
Disallow: /checkout/
Disallow: /account/

# Боты по запросу пользователя: разрешаем
User-agent: ChatGPT-User
User-agent: Claude-User
User-agent: Perplexity-User
Allow: /
Disallow: /checkout/
Disallow: /account/

# Обучающие краулеры и токены: отказываемся
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
Disallow: /

# Все остальные, включая Googlebot и Bingbot
User-agent: *
Disallow: /checkout/
Disallow: /account/

Sitemap: https://www.example.com/sitemap.xml
Не упустите четыре детали:
- Повторяйте закрытые разделы в каждой именной группе. Краулер выполняет только самую конкретную группу, которая к нему подходит. Как только вы выделили OAI-SearchBot в отдельную группу, он перестаёт учитывать всё, что написано под
User-agent: *, включая правило для/checkout/. - Решение по Google-Extended принимайте отдельно. В шаблоне он стоит в группе отказа, но этот токен касается ещё и граундинга в приложениях Gemini. Если видимость в Gemini для вас важнее отказа от обучения, удалите эту строку.
- В строке Sitemap указывайте полный адрес. Строка может стоять в любом месте файла, но адрес должен быть абсолютным и вести на карту сайта, которая действительно открывается.
- Замедляйте ботов вместо блокировки. Если вас беспокоит нагрузка на сервер, Anthropic поддерживает нестандартную директиву
Crawl-delay, напримерCrawl-delay: 1. Добавьте её в группу, где перечислены только боты Anthropic. Это лучше, чем закрывать её поисковый краулер.
Если вы согласны, чтобы контент использовали и для обучения, удалите группу обучающих ботов: тогда они будут следовать группе *. OpenAI отмечает, что если разрешены и GPTBot, и OAI-SearchBot, компания может использовать один обход для обеих целей.
Как проверить, что правила robots.txt действительно работают?
Правильный файл на вашем компьютере мало что доказывает. Важно, что получает каждый бот, когда обращается к сайту. Пройдите шаги по порядку.
- Проверьте настройки ботов в CDN и WAF. Найдите переключатели блокировки ИИ-ботов, управляемый robots.txt, режимы борьбы с ботами и лимиты запросов. Если robots.txt управляет CDN, он может заменить загруженный вами файл или дописать в него строки.
- Откройте живой robots.txt на каждом хосте. Проверьте вашсайт.kz, www.вашсайт.kz и все поддомены с контентом: у каждого хоста должен быть свой файл. В ответ должен приходить код 200 и простой текст, а не HTML-страница, форма входа или CAPTCHA. По протоколу исключений для роботов (RFC 9309) краулеры обязаны считать robots.txt, который отвечает ошибкой сервера (5xx) или недоступен, полным запретом.
- Проверьте каждую группу User-agent. Прочитайте файл глазами каждого бота: найдите группу с его именем, а если такой нет — группу
*. Убедитесь, что результат совпадает с таблицей выше. Следите за опечатками: группу с ошибкой в имени бота не использует ни один бот. - Посмотрите логи сервера. Отфильтруйте записи по user agent: GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, Claude-SearchBot, Claude-User, PerplexityBot и Perplexity-User. Ищите ответы 403, 429 и 5xx. Google-Extended и Applebot-Extended в логах не появятся никогда: это токены, а не краулеры. OpenAI пишет, что OAI-SearchBot и GPTBot могут добавлять к user agent пометку «robots.txt», когда запрашивают этот файл, — так эти запросы можно отличить от запросов к страницам.
- Сверяйте IP-адреса ботов, прежде чем вносить их в белый список. Подделать user agent может кто угодно. OpenAI публикует диапазоны IP-адресов на openai.com/searchbot.json, openai.com/gptbot.json и openai.com/chatgpt-user.json и рекомендует разрешить диапазоны OAI-SearchBot. Perplexity тоже публикует диапазоны своих ботов. Для Anthropic следуйте инструкциям по проверке на её странице справки.
- Проверьте ссылку на карту сайта. Откройте адрес из строки Sitemap. Убедитесь, что карта загружается, не закрыта для ботов и содержит важные страницы: услуги, цены, контакты.
- Подождите и проверьте ещё раз. По словам OpenAI, поисковым системам компании нужно около 24 часов, чтобы учесть изменения в robots.txt. После этого снова посмотрите логи.
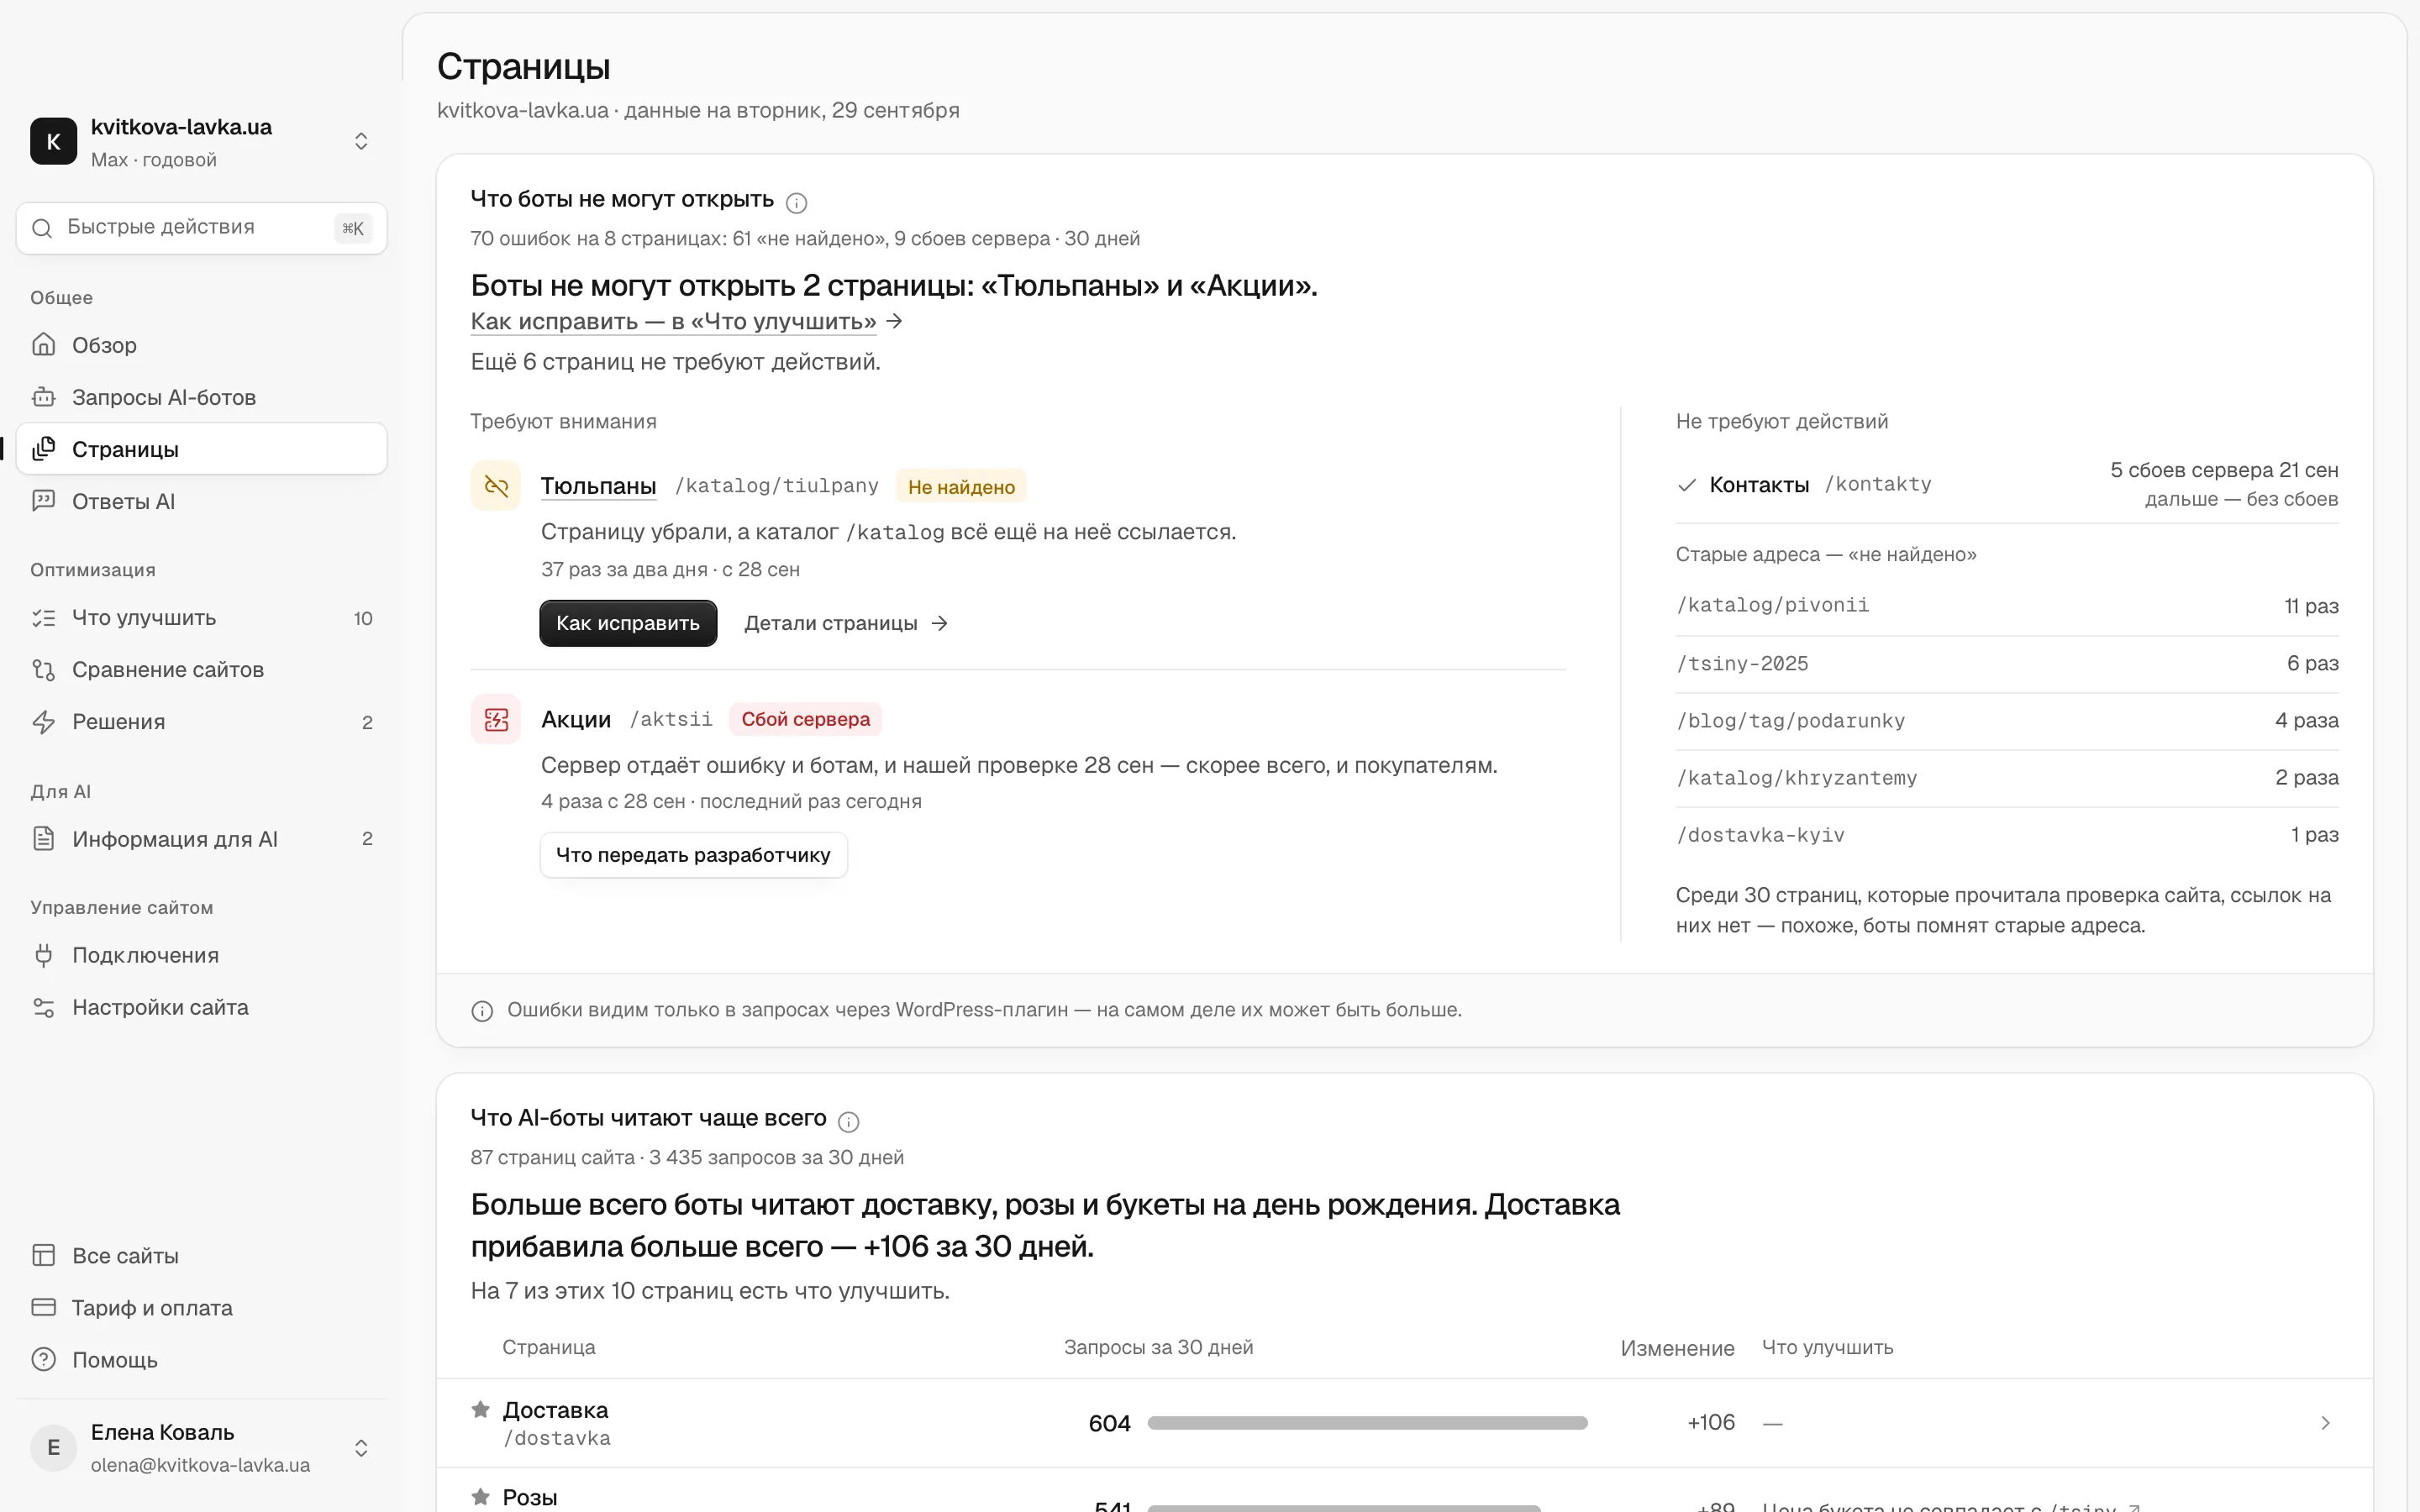
Каждую неделю разбирать сырые логи долго. Pulse делает это за вас: показывает, какие ИИ-боты ChatGPT, Claude, Gemini и других сервисов на самом деле заходят на сайт, что они читают и где получают ошибки. К каждой проблеме прилагается совет, что изменить.
Чего robots.txt не умеет?
Robots.txt — это просьба, а не замок. В RFC 9309 сказано, что его правила «не являются формой авторизации доступа». Добросовестные краулеры их соблюдают, но заставить их это делать нельзя. В августе 2025 года Cloudflare сообщила, что Perplexity использовала незаявленных краулеров, чтобы обходить запреты на сканирование. Perplexity это оспорила. Если контент должен оставаться закрытым, спрячьте его за авторизацией.
Robots.txt — лишь один из сигналов, которые можно передать ИИ-системам. В нашем исследовании о llms.txt и других сигналах для ИИ-краулеров в 2026 году разобраны llms.txt, метатеги и другие инструменты и объяснено, что делает каждый из них.
Что сделать на этой неделе?
Начните с самой быстрой проверки. Откройте в браузере вашсайт.kz/robots.txt, найдите группы для OAI-SearchBot, Claude-SearchBot и PerplexityBot, затем загляните в настройки ботов в CDN. За несколько минут вы поймёте, могут ли вообще до вас добраться боты, из данных которых собираются ответы ИИ.
Чтобы увидеть всю картину сразу, пройдите бесплатную проверку сайта на видимость в ИИ. Она покажет, как ИИ видит ваш бизнес и что сделать, чтобы он называл вас, а не конкурентов.
Частые вопросы
Если закрыть GPTBot, ChatGPT перестанет ссылаться на мой сайт?
Нет. GPTBot собирает контент, который может использоваться для обучения моделей OpenAI, и, по словам OpenAI, настройки для каждого краулера не зависят друг от друга. Поиск ChatGPT работает через OAI-SearchBot, поэтому можно запретить GPTBot и при этом разрешить OAI-SearchBot. Доступ для OAI-SearchBot даёт возможность попасть в ссылки, но не гарантирует этого.
Соблюдает ли ChatGPT-User правила robots.txt?
Не всегда. OpenAI пишет, что правила robots.txt могут не применяться к ChatGPT-User, потому что запрос запускает пользователь. Perplexity сообщает, что Perplexity-User по той же причине, как правило, игнорирует robots.txt. Anthropic пишет, что её боты, включая Claude-User, robots.txt соблюдают. Если эти боты не могут открыть ваши страницы, проверьте, не отдают ли правила файрвола и CDN ответ 403 или проверку.
Если закрыть Google-Extended, сайт пропадёт из обзоров от ИИ в Google?
Нет. Google-Extended определяет, используется ли ваш контент для обучения Gemini и граундинга в приложениях Gemini. На попадание в Google Поиск и позиции в нём он не влияет. Обзоры от ИИ (AI Overviews) и режим ИИ (AI Mode) работают через Googlebot и обычные настройки Поиска.
Если сейчас закрыть GPTBot или ClaudeBot, мой старый контент удалят из обучающих данных?
Рассчитывать на это не стоит. В документации Anthropic сказано, что ограничение ClaudeBot исключает из обучающих наборов будущие материалы сайта. Считайте блокировку сигналом на будущее, а не просьбой удалить уже собранные данные.
Через сколько времени изменения в robots.txt учтёт поиск ChatGPT?
По словам OpenAI, её поисковым системам нужно около 24 часов, чтобы учесть обновление robots.txt. После этого проверьте логи сервера и убедитесь, что OAI-SearchBot получает ответы 200.
Cloudflare блокирует ИИ-ботов по умолчанию?
1 июля 2025 года Cloudflare объявила, что по умолчанию блокирует известных ИИ-краулеров на новых доменах, а владельцы могут разрешить им доступ. Если ИИ-боты не добираются до вашего сайта, проверьте в Cloudflare настройки ботов и ИИ-краулеров, а также управляемый robots.txt, если он включён.