Закрывать ли сайт от обучения ИИ? Я бы закрывал, только если сам контент и есть то, что вы продаёте. Для большинства малых и средних компаний решение об обучении весит меньше, чем кажется. Настоящий риск в другом: заблокировать ботов, которые открывают ваши страницы, когда ChatGPT, Copilot, Gemini или Perplexity собирают ответ. Владельцы сайтов часто блокируют их случайно, вместе с ботами для обучения. Моё правило простое: об обучении решайте исходя из того, как вы зарабатываете, а ботов для ответов держите открытыми.
Сейчас для этого удачный момент. 30 октября 2026 года Microsoft Bing объявил отдельные, независимые друг от друга настройки для обучения ИИ и для использования контента в ответах (grounding). В тот же день Google и OpenAI сообщили, что собираются учитывать единый сигнал об обучении в robots.txt. Впервые у большинства владельцев сайтов появилась возможность принять эти два решения по отдельности.
Обучение и ответы — это две разные задачи
Определения Microsoft — самые ясные из тех, что я видел. Обучение ИИ — это использование вашего контента, чтобы изменить выученные параметры модели. Grounding — это использование вашего контента как исходных данных для ответа, который генерирует ИИ. Индексация и ранжирование страниц в обычной поисковой выдаче не относятся ни к тому, ни к другому.
Обучение работает опосредованно: ваша страница становится одним из множества источников, на которых учится модель. Grounding происходит в момент вопроса. Клиент спрашивает, бот открывает вашу страницу, и ассистент может назвать вас и дать ссылку. Если вы закрыли сайт для ответов, ассистент не сможет использовать вашу страницу. Он соберёт ответ из других источников, и среди них могут оказаться ваши конкуренты.
До этой осени большинство владельцев сайтов считали обучение и ответы одним решением. С 2023 года Microsoft управлял и тем и другим через NoArchive и NoCache. Токен Google-Extended у Google до сих пор охватывает оба случая. Длинные списки «заблокируйте всех AI-ботов» смешивали оба типа. У OpenAI, Anthropic и Perplexity отдельные боты были и раньше, но мало кто читал документацию так внимательно.
| Бот или токен | Что делает | Категория |
|---|---|---|
| GPTBot (OpenAI) | Определяет, используется ли ваш контент для обучения | Обучение |
| OAI-SearchBot (OpenAI) | Определяет, может ли сайт появляться в результатах поиска ChatGPT | Ответы |
| ChatGPT-User (OpenAI) | Открывает страницу, когда об этом просит пользователь ChatGPT | Ответы |
| ClaudeBot (Anthropic) | Собирает данные для обучения | Обучение |
| Claude-SearchBot, Claude-User (Anthropic) | Улучшают результаты поиска и открывают страницы по вопросам пользователей | Ответы |
| PerplexityBot, Perplexity-User | Показывают сайты со ссылками в ответах Perplexity; открывают страницы по действиям пользователя | Ответы |
| Google-Extended (токен, а не краулер) | Обучение Gemini и, по данным СМИ, использование в ответах приложений Gemini | И то и другое |
| Googlebot, Bingbot | Поиск, а также AI Overviews и AI Mode у Google и grounding для Copilot у Microsoft | Ответы |
Роли ботов взяты из публикации о краулерах OpenAI, справочного центра Anthropic, руководства Perplexity по краулерам и списка краулеров Google. Одна деталь: правила robots.txt могут не действовать на боты, которые работают по запросу пользователя, например ChatGPT-User и Perplexity-User, — ведь страницу попросил человек. А вот блокировка в файрволе их останавливает. Синтаксис robots.txt повторять не буду: в нашей карте llms.txt и других сигналов для AI-краулеров в 2026 году показано, как эти сигналы работают вместе.
Что изменилось 30 октября 2026 года, а что нет
Общий сигнал — это группа в robots.txt с названием User-Agent: __usage_ai-training. Она описана в IETF Internet-Draft, который подготовил Кевин Келли из Anthropic. Internet-Draft — это рабочее предложение, а не готовый стандарт. Google будет считать отказ через этот токен запретом для Google-Extended, если вы не указали Google-Extended отдельно. OpenAI обещает учитывать токен в ближайшие месяцы, а до тех пор действуют её нынешние правила robots.txt. По сообщениям СМИ, Anthropic уже начала внедрение, но страницы Anthropic, которая бы это подтверждала, я не видел.
Не менее важно, что не изменилось. Согласно черновику, опубликованные сегодня файлы robots.txt не выражают никакого общего предпочтения: такой группы в них пока нет. Работают ваши нынешние правила для GPTBot, ClaudeBot и Google-Extended. OpenAI, Google и Anthropic говорят, что настройки для отдельных ботов сохранятся.
| Дата | Что происходит |
|---|---|
| 15 декабря 2026 | В Bing Webmaster Tools появляются временные настройки grounding — только для сайтов, которые используют NoArchive/NoCache |
| 1 февраля 2027 | Bing начинает применять новые настройки по мере повторного обхода страниц |
| 1 марта 2027 | Bing перестаёт читать NoArchive/NoCache для обучения и grounding |
| 3 мая 2027 | Истекает срок действия текущего Internet-Draft |
| 30 сентября 2027 | Истекают временные настройки grounding в Bing |
| 2027 / «ближайшие месяцы» | Поддержка общего токена у Google / OpenAI |
Где разделение пока неполное
Google: обучение и ответы Gemini идут вместе
Search Engine Journal и Dataconomy пишут, что Google-Extended охватывает и grounding в приложениях Gemini, а способа разделить эти два использования документация Google не описывает. Значит, отказавшись от обучения через новый токен, вы можете выпасть и из ответов приложений Gemini. Отдельная группа Google-Extended имеет приоритет над общим токеном, но это всё равно один переключатель на оба случая. Google Поиск, AI Overviews и AI Mode это не затрагивает: ими управляет Googlebot, а не Google-Extended.
Microsoft: grounding настраивается для каждой страницы
В Bing обучение можно настроить для всего сайта в robots.txt и переопределить для отдельных страниц. Grounding настраивается только постранично — через метатег или заголовок X-Robots-Tag. Microsoft прямо пишет: «Настройки grounding на уровне всего сайта в robots.txt нет». Обе настройки по умолчанию разрешают использование. Есть и промежуточный вариант — ai-grounding:disallowextended. Он оставляет ваши страницы доступными для собственных сервисов Microsoft, таких как Copilot и Microsoft 365, но исключает сервисы grounding, которые Microsoft продаёт третьим компаниям.
Эти настройки определяют, как Microsoft использует ваш контент, а не может ли Bingbot его сканировать. Разрешение не отменяет правило robots.txt, которое блокирует Bingbot. И Microsoft увидит новую настройку только после повторного обхода страницы.
Правило со звёздочкой — это не отказ
По черновику группу User-Agent: * нельзя считать предпочтением насчёт обучения. Если вам кажется, что ваши общие правила уже говорят «не обучать», в новой системе они не говорят ничего.
Закрывать ли сайт от обучения ИИ: правило для решения
Задайте себе один вопрос: ваш контент сам по себе и есть продукт, который вы продаёте? Если нет, обучение на страницах ваших услуг почти ничего вам не стоит. Если да — защищайте его.
| Бизнес | Обучение ИИ | Ответы ИИ |
|---|---|---|
| Локальные услуги, клиника, юридическая фирма, агентство | Решать вам; я склоняюсь к «разрешить» | Оставить открытыми |
| Интернет-магазин, SaaS, B2B-лидогенерация | Решать вам; я склоняюсь к «разрешить» | Оставить открытыми |
| Издание с платным архивом или архивом, который можно лицензировать | Запретить или лицензировать | Открыть для публичных страниц; в Bing рассмотреть DisallowExtended |
| Контент — это продукт: курсы, данные, рецепты, фотобанки | Запретить | Решать постранично: открыть продающие страницы, закрыть сам продукт |
Условный пример: стоматологическая клиника в Алматы. Её цены, часы работы и список процедур — не продукт, который кто-то может перепродать. Запрет обучения не защищает ничего ценного. А запрет ответов означает, что ChatGPT не сможет проверить эти факты, когда пациент спросит, какая клиника есть поблизости.
«Но ИИ отнимает у меня трафик»: самые сильные возражения
Издатели с контентом, который можно лицензировать
Опасение справедливое. Если ваш архив стоит денег, отказ от обучения — разумный выбор. Но Bing пишет, что его настройки «не устанавливают лицензионных или платёжных договорённостей». А черновик позволяет частным соглашениям, например лицензионным сделкам, иметь приоритет над общим сигналом. То есть токен сохраняет вам варианты, но не ведёт переговоры за вас. И чтобы сохранить эти варианты, не нужно убирать публичные страницы из ответов.
Сводки ИИ сокращают клики
Да, сокращают. Pew Research Center изучил данные о просмотрах 900 взрослых американцев за март 2025 года. Пользователи, которые видели AI-сводку Google, кликали на обычный результат в 8% визитов, а без сводки — в 15%. На ссылку внутри сводки они кликали примерно в 1% визитов. Это реальная потеря. Но запрет ответов не вернёт старую поисковую выдачу. Он лишь уберёт вас из сводки, которая теперь стоит на этой странице.
Блокировка не возвращает клики
Единственные данные, которые я видел, говорят об обратном, и их мало. В пересказе одной публикации описан сайт, который тестировал SEO-специалист Сайрус Шепард. Обычные органические клики сайта упали, пока его не было в AI Overviews и AI Mode, и восстановились, когда он вернулся. Это один сайт, сам по себе он ничего не доказывает. Но убедительных данных в пользу обратного я тоже не видел.
Открытый доступ — не гарантия, поэтому измеряйте
Microsoft говорит прямо: «Ни один из вариантов не гарантирует включения, трафика или оплаты». Если вы запретите grounding, Microsoft предупреждает, что видимость бренда в AI-сервисах снизится. Если разрешите — ваши страницы лишь получат шанс попасть в ответы. Назовёт ли вас ассистент, зависит от ясных, уникальных фактов на этих страницах и от того, что о вас пишут другие источники.
Поэтому я считаю, что видимость в ИИ нужно измерять до и после изменений, а не обещать. Подход описан в нашем исследовании Share of Model и измерение видимости в ИИ. В кейсе Sereda.ai ChatGPT сначала отвечал, что не знает эту HR-платформу. Sereda.ai опубликовала AI Page 22 октября 2025 года. Два исследователя независимо оценивали ответы на 4 вопроса по 5 критериям по 100-балльной шкале. Оценка выросла с 24 до 87 в ChatGPT и с 28 до 91 в Gemini. «До» — сентябрь — начало октября 2025 года, «после» — начало декабря 2025 года. Это один кейс, а не типичный результат.
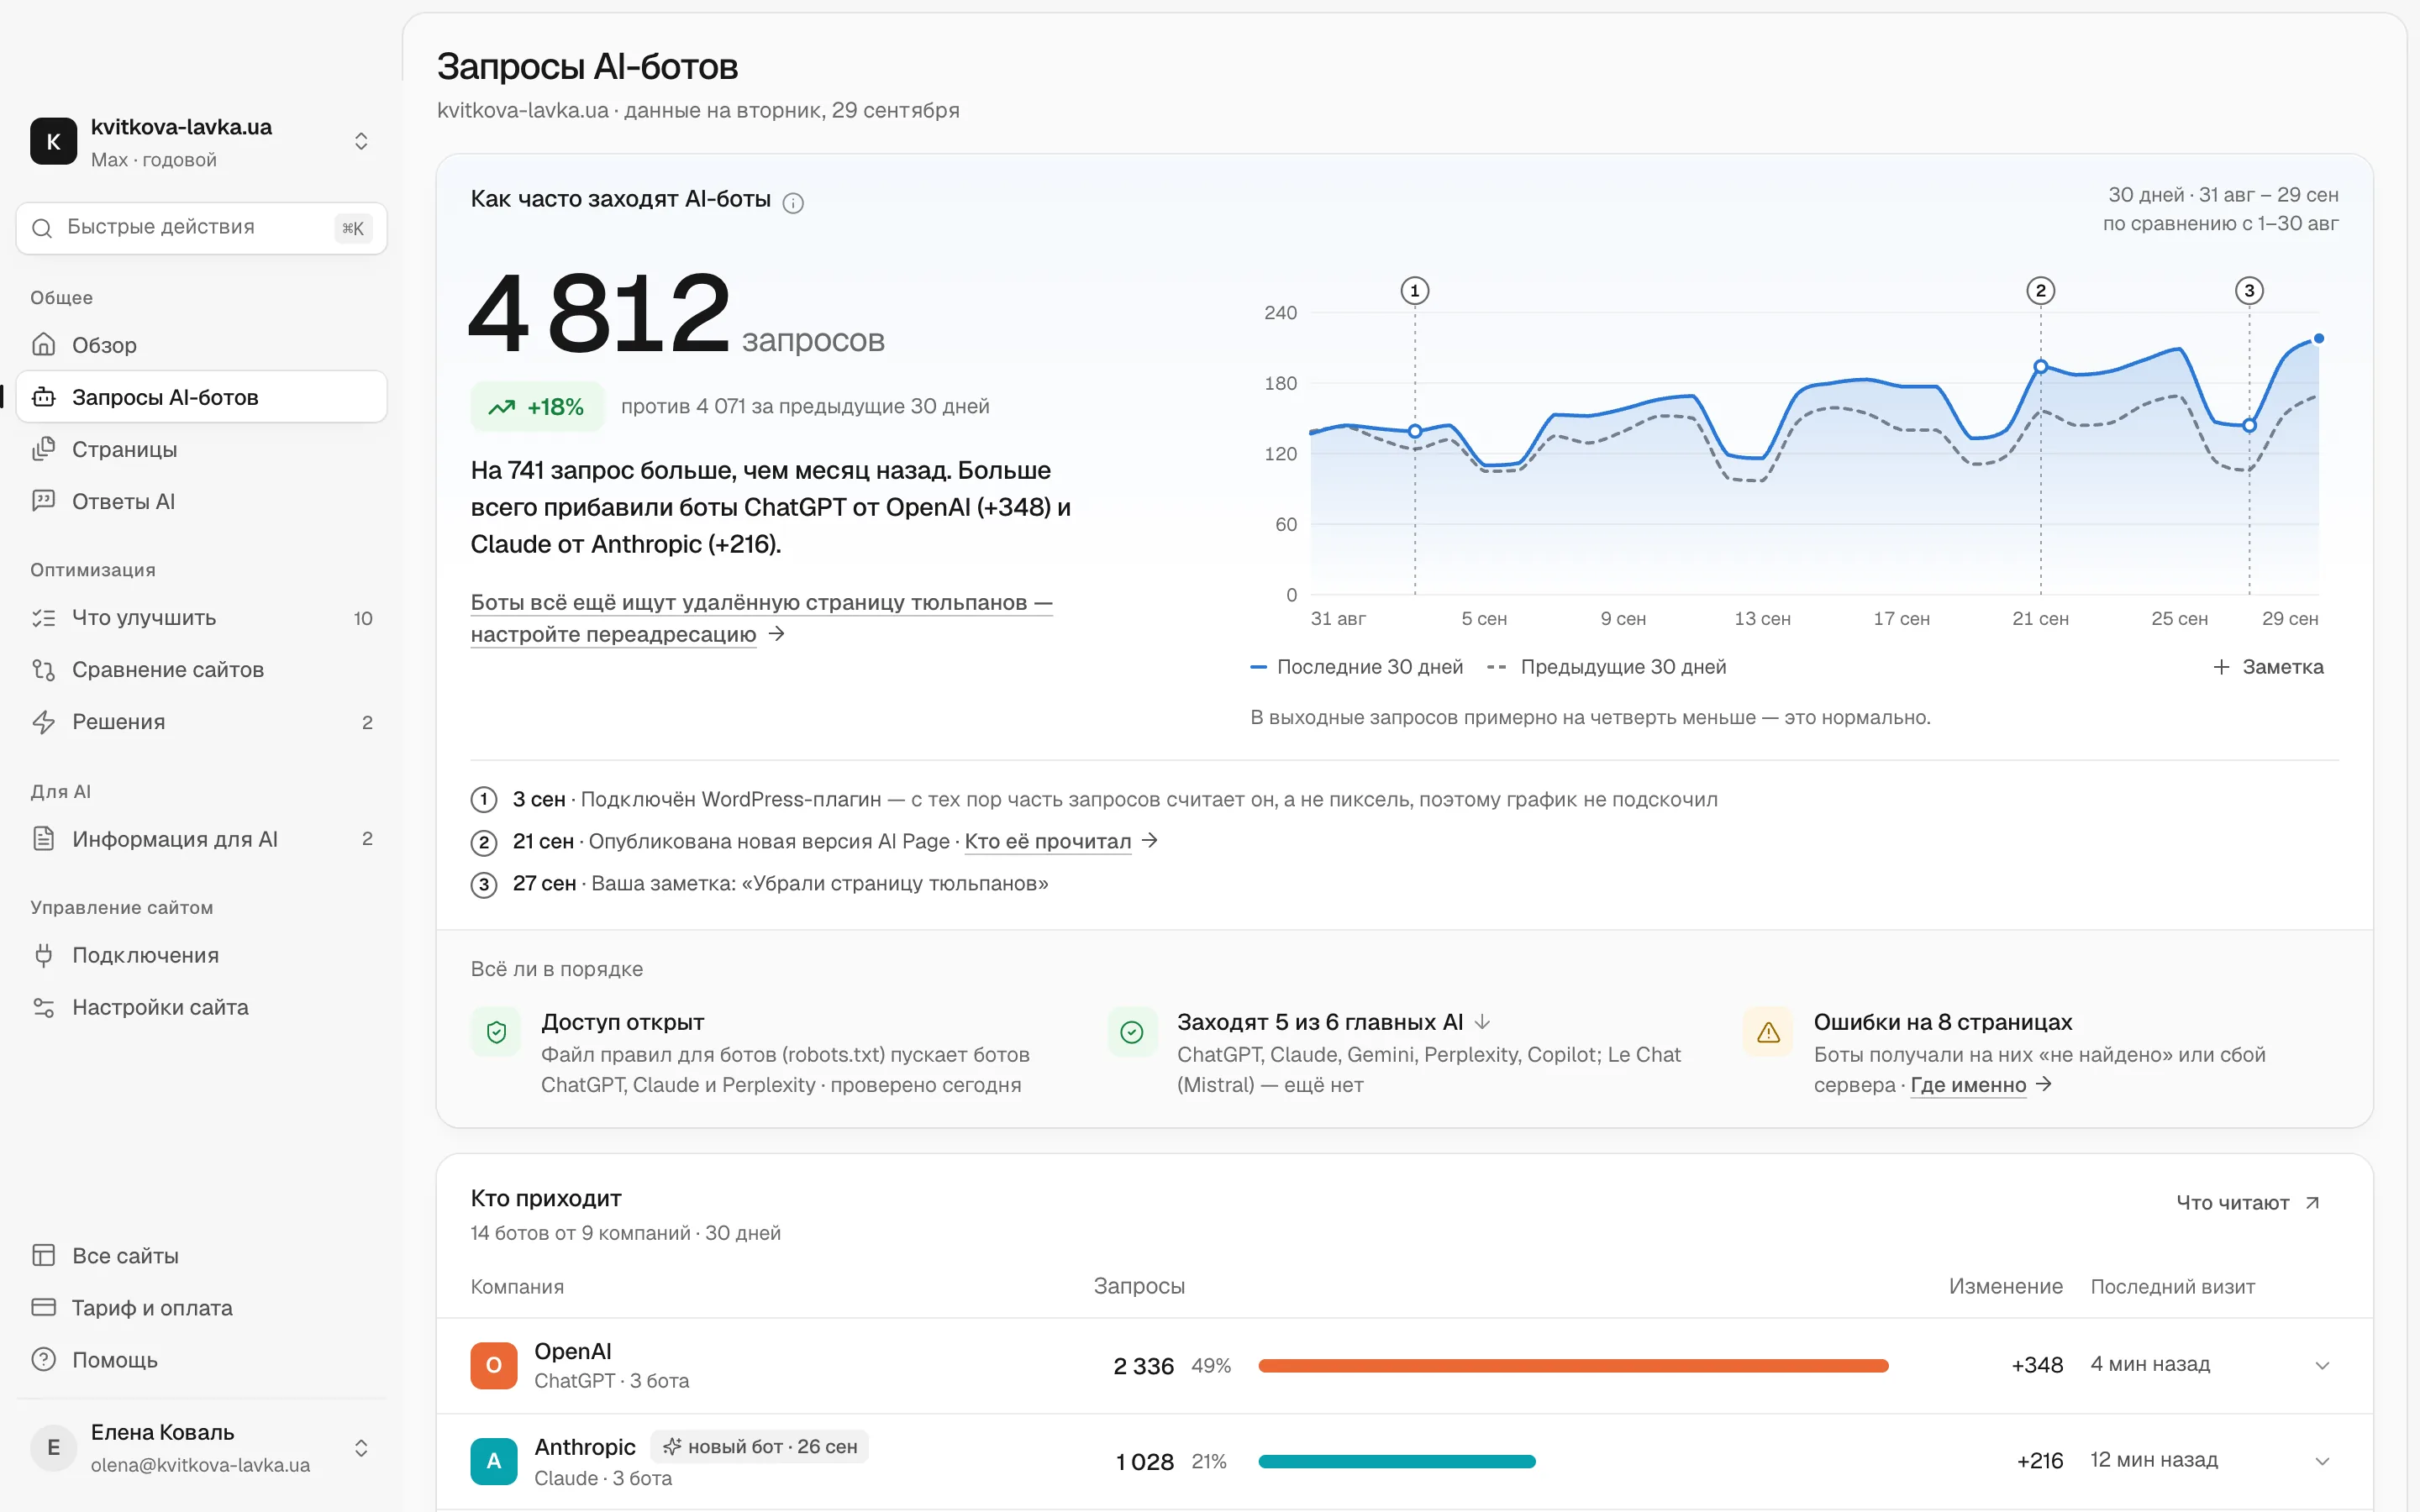
С технической стороны проверьте логи сервера. Боты для ответов должны получать ответ 200, а не ошибки 403, циклические редиректы или проверки файрвола. User-agent можно подделать, поэтому проверяйте важных ботов по IP или обратному DNS. Если читать сырые логи не хочется, Chetver Pulse покажет, какие AI-боты заходят на сайт, что читают и где натыкаются на ошибки.
Что бы я сделал на вашем месте
- Посмотрите, что ваш сайт отдаёт на самом деле. Откройте живой robots.txt и проверьте метатеги robots и заголовки X-Robots-Tag на ключевых страницах. Настройки CDN и файрвола могут менять файл незаметно для вас. HasData сообщила об изменении в Cloudflare, которое убрало запреты для ИИ из robots.txt 118 сайтов.
- Пометьте каждое правило: «обучение» или «ответы». Правило, которое блокирует OAI-SearchBot, ChatGPT-User, Claude-User, PerplexityBot, Bingbot или Googlebot, должно стоять только потому, что вы так решили осознанно.
- Если хотите отказаться от обучения, добавьте отдельную группу
__usage_ai-training. Правила для GPTBot, ClaudeBot и Google-Extended пока оставьте. Осознанно решите, готовы ли вы потерять ответы в приложениях Gemini. - Если используете NoArchive или NoCache в Bing, запланируйте переход до 1 марта 2027 года. Перенесите обучение в новую группу robots.txt, а grounding — в постраничные теги.
- После каждого изменения снова проверяйте логи. Боты для ответов должны по-прежнему получать ответ 200.
Начните с первого шага сегодня. Это быстро, и вы увидите, какие решения ваш сайт уже принял без вас.
Частые вопросы
Если закрыть сайт от GPTBot, он пропадёт из поиска ChatGPT?
Нет. GPTBot определяет, используется ли ваш контент для обучения. OAI-SearchBot определяет, может ли сайт появляться в результатах поиска ChatGPT, и эти две настройки задаются независимо. ChatGPT-User открывает страницы, когда об этом просит пользователь ChatGPT.
Что такое __usage_ai-training и работает ли он уже?
Это общая группа в robots.txt, через которую можно выразить предпочтение насчёт обучения ИИ. Она описана в IETF Internet-Draft. У крупных разработчиков она пока не работает: Microsoft начнёт применять её с 1 февраля 2027 года, Google планирует поддержку в 2027 году, OpenAI говорит о ближайших месяцах. До тех пор действуют ваши нынешние правила для отдельных ботов, например GPTBot и Google-Extended.
Если запретить обучение ИИ, я пропаду из Gemini?
Может быть. Google будет считать отказ через общий токен запретом для Google-Extended. По данным СМИ, Google-Extended охватывает и использование страниц в ответах приложений Gemini. Google Поиском, AI Overviews и AI Mode управляет Googlebot, поэтому на них отказ не влияет.
Считается ли User-Agent: * Disallow отказом от обучения ИИ?
По новому черновику — нет. Группу со звёздочкой нельзя считать предпочтением насчёт обучения. Файл robots.txt без группы __usage_ai-training не выражает общего предпочтения. Если хотите отказаться от обучения, нужна отдельная группа.
Я использую NoArchive или NoCache в Bing. Что делать?
Запланируйте переход до 1 марта 2027 года. После этой даты Bing перестанет читать NoArchive и NoCache для обучения и grounding. Обучение настройте через группу __usage_ai-training в robots.txt, а grounding — через метатеги на страницах или заголовок X-Robots-Tag.
Если я открою сайт для AI-ботов, ИИ-ассистенты будут меня упоминать?
Не обязательно. Microsoft пишет, что ни один из вариантов не гарантирует включения, трафика или оплаты. Открытый доступ даёт вашим страницам шанс попасть в ответы. Назовёт ли вас ассистент, зависит от ясных, уникальных фактов на ваших страницах и от того, что о вас пишут другие источники.