Нужен ли вашему сайту llms.txt? Для большинства сайтов бизнеса это не срочно. llms.txt — необязательный Markdown-файл в корне сайта со списком ключевых страниц для языковых моделей. Это предложенная договорённость, а не стандарт вроде robots.txt, и сам файл не гарантирует, что ChatGPT, Gemini или другой ассистент начнёт вас упоминать.
При этом добавить его недорого, и вреда от него нет. Ниже объясняем, что это за файл и что публично известно о том, кто его читает. Затем разбираем, когда на него стоит тратить время, как его составить и как проверить, запрашивает ли его хоть один бот.
Что такое llms.txt и чем он отличается от robots.txt и sitemap.xml?
llms.txt — это «предложение стандартизировать использование файла /llms.txt, чтобы дать агентам информацию, которая поможет им пользоваться сайтом». Впервые его опубликовал Джереми Говард (Jeremy Howard) из Answer.AI 3 сентября 2024 года. Текущая версия — v2, страница предложения последний раз обновлялась 10 августа 2026 года.
Файл пишется в Markdown — простом текстовом формате, где # обозначает заголовок, а [название](url) — ссылку. По спецификации обязателен только один элемент: заголовок H1 с названием сайта или проекта. Дальше можно добавить цитату (blockquote) с кратким описанием, немного свободного текста и разделы H2 со списками ссылок. После каждой ссылки через двоеточие можно дать короткое пояснение.
Само предложение разводит llms.txt и robots.txt. robots.txt сообщает автоматическим инструментам, какой доступ допустим. llms.txt рассчитан на чтение по запросу, когда агенту нужна информация, чтобы помочь пользователю. Автор предполагал, что файл будет важен в основном для инференса (ответов на вопросы), а не для обучения моделей.
В предложении также объясняется, почему карта сайта не справится с этой задачей. В sitemap часто нет версий страниц, удобных для чтения языковой моделью, нет полезных внешних ссылок, и обычно там гораздо больше страниц, чем помещается в контекстное окно модели (объём текста, с которым модель может работать за один раз).
| robots.txt | sitemap.xml | llms.txt | |
|---|---|---|---|
| Назначение | Указывает, каким краулерам какие разделы доступны | Перечисляет URL, которые поисковики должны найти | Даёт ИИ-агентам короткую отобранную карту ключевых страниц |
| Кто читает | Поисковые и ИИ-краулеры, соблюдающие протокол | Поисковые системы | Ни один крупный ИИ-ассистент не заявляет об этом в документации. Используют агенты для программирования и некоторые инструменты |
| Управляет доступом? | Да, для краулеров, которые его соблюдают | Нет | Нет |
| Формат | Текстовые директивы | XML | Markdown |
| Статус | Стандарт IETF (RFC 9309) | Устоявшийся протокол sitemaps | Предложение сообщества (v2, август 2026) |
Что изменилось в llms.txt v2
Многие статьи до сих пор описывают первую версию. Если вы добавляете файл сейчас, важны изменения v2:
- Файлы в подразделах. Файл может лежать по адресу
/llms.txtили в любом подразделе, например/docs/llms.txt. Он охватывает URL внутри своего пути, а агенты должны использовать самый конкретный файл. - Markdown-версии страниц. Предложение рекомендует чистые Markdown-копии страниц: либо с добавленным
.md(page.html.md), либо с заменой расширения (page.md). Допустимы оба варианта. - Обнаружение через связи ссылок. Страница может указать на свою Markdown-версию через
rel="alternate" type="text/markdown", а на охватывающий её llms.txt — черезrel="describedby". Для этого подходит HTML-элемент<link>или HTTP-заголовокLink:. - Раздел «Optional» теперь просто договорённость. Его по-прежнему можно использовать для второстепенных ссылок, но особого технического смысла у него больше нет.
Какие ИИ-системы на самом деле читают llms.txt?
Если коротко, по первоисточникам ни один крупный ИИ-ассистент не заявляет в документации, что использует llms.txt чужих сайтов для ответов. Вот что каждая сторона говорила публично.
Google: команда Поиска говорит, что не использует его
17 июня 2025 года Джон Мюллер (John Mueller) из Google написал: «К слову, ни одна ИИ-система сейчас не использует llms.txt». Он добавил, что чат-боты запрашивают страницы для обучения и для опоры ответов на источники (grounding), но не файл llms.txt, и что это хорошо видно по логам сервера.
В 2026 году он говорит то же самое. На Reddit Мюллер назвал этот вопрос «чисто гипотетическим», потому что ни один ИИ-сервис не требует и не использует этот файл. Он также заметил, что llms.txt не может помочь модели выбрать между сайтами, ведь его пишет тот самый сайт, который хочет, чтобы выбрали его. На вопрос, означают ли файлы llms.txt на собственных сайтах Google для разработчиков, что компания их одобряет, он ответил «нет».
Рекомендации Google 2026 года по оптимизации для ИИ-функций Поиска идут дальше. Согласно пересказам Optimizely и Contentful, в них сказано, что для появления в AI Overviews или AI Mode не нужны ни llms.txt, ни другие специальные текстовые или Markdown-файлы для ИИ. Наличие такого файла на позиции не влияет ни в плюс, ни в минус.
OpenAI, Anthropic и Perplexity: в документации robots.txt, а не llms.txt
Документация OpenAI о краулерах описывает OAI-SearchBot, который показывает сайты в поиске ChatGPT, и GPTBot, который собирает данные для обучения. Каждым из них управляют отдельно в robots.txt. Никакой роли llms.txt в документации нет. Документации Anthropic или Perplexity о том, что их ассистенты читают llms.txt чужих сайтов, мы тоже не нашли.
Путаницу создаёт то, что эти компании сами публикуют llms.txt. На llmstxt.org перечислены developers.openai.com/llms.txt, docs.anthropic.com/llms.txt и ai.google.dev/gemini-api/docs/llms.txt. Эти файлы помогают разработчикам и инструментам для программирования ориентироваться в документации самих компаний. Публиковать свой файл — не то же самое, что читать ваш.
Что показывают исследования и логи серверов
- SE Ranking проанализировал около 300 000 доменов и нашёл llms.txt на 10,13% из них. Ни статистическая корреляция, ни модель машинного обучения не показали влияния файла на то, как часто ИИ цитирует эти сайты. Более того, без переменной llms.txt модель стала точнее.
- Исследования логов, собранные Optimizely, показали, что файл запрашивают очень редко. Limy зафиксировал 408 запросов к llms.txt на более чем 500 млн визитов ИИ-ботов за 90 дней. Otterly — 84 запроса на более чем 62 100 визитов ИИ-ботов за 90 дней, около 0,1%.
- Оценки распространённости зависят от выборки. SE Ranking Visible приводит 13,3% из 37 894 доменов, которые цитирует ИИ (Trakkr, март 2026), и корректный файл на 5,61% из топ-10 000 сайтов (HTTP Archive, июнь 2026).
Где llms.txt действительно используют
Согласно предложению, активнее всего файлы используют в документации к программам: агенты для программирования переходят по ним к справочникам API и руководствам. Там же отмечено, что Lighthouse в Chrome проверяет наличие llms.txt в аудитах агентного браузинга. Это проверка инструмента, а не доказательство того, что ИИ-ответы используют файл.
Нужен ли вам llms.txt: когда его стоит добавить и что исправить в первую очередь
Относитесь к llms.txt как к недорогому наведению порядка, а не как к рычагу видимости. Стоит ли он 10 минут вашего времени, зависит от сайта.
Когда llms.txt стоит добавить
- Документация, SaaS и API-продукты. Именно здесь файл реально используют агенты для программирования и инструменты документации. Больше всего выигрывают продукты для разработчиков.
- Сайты, сильно зависящие от JavaScript. Если цены или описания услуг появляются только после выполнения скриптов, Markdown-карта со ссылками на чистые версии страниц может стать запасным вариантом для агентов, которые читают сырой текст. Исправлять сами страницы это не заменяет.
- Сервисный бизнес, факты которого трудно извлечь. У клиник, юридических фирм и местных служб цены, часы работы и адреса часто разбросаны по многим страницам. Если собрать их в одном файле, заодно придётся проверить, что все факты верны.
- Ваша платформа уже создаёт файл. По данным llmstxt.org, Yoast SEO, AIOSEO, Wix, Mintlify и GitBook умеют генерировать его автоматически. Wix создаёт его для каждого сайта. Если файл уже есть, оставьте его, но откройте и проверьте, те ли страницы в нём перечислены.
Когда llms.txt не в приоритете: сначала исправьте это
- robots.txt блокирует ИИ-краулеры. Если GPTBot, OAI-SearchBot, ClaudeBot или PerplexityBot запрещены — иногда через настройку CDN или правила, скопированные с другого сайта, — llms.txt ничего не изменит. В нашей карте директив robots.txt и других сигналов для ИИ-краулеров видно, какие правила важны.
- Боты получают ошибки или проверки. Ответы 4xx и 5xx, страницы с CAPTCHA и проверки файрвола останавливают ботов до того, как они что-то прочитают.
- Ключевых фактов нет на страницах. Если цены, часы работы, зона обслуживания или контакты не написаны в HTML страниц, начните с этого. Как заметил Мюллер, ИИ по-прежнему находит информацию через обычные страницы и внутренние ссылки.
Как создать файл llms.txt: пошаговая инструкция
- Выберите 5–20 страниц, которые отвечают на реальные вопросы клиентов: услуги, цены, часы работы, адреса, контакты, правила, а для софта — документацию.
- Напишите H1 с названием бизнеса или продукта. Это единственный обязательный элемент.
- Добавьте цитату из одного-двух предложений: чем вы занимаетесь, для кого и где.
- По желанию добавьте короткий абзац с ключевыми фактами. Пишите простыми утверждениями, без рекламных формулировок.
- Сгруппируйте ссылки по разделам H2, например «Услуги и цены», «Контакты и часы работы», «Условия». После каждой ссылки через двоеточие добавьте короткое пояснение.
- Ведите ссылки на чистые страницы: на
.md-версии, если они есть, или на лёгкие HTML-страницы со статусом 200. - Сохраните файл как обычный текст в UTF-8 и загрузите его по адресу
/llms.txt. Для документации в отдельной папке используйте подраздел, например/docs/llms.txt. - Откройте URL и проверьте ответ: статус 200, текстовый тип содержимого (
text/plainилиtext/markdown), без редиректа на главную и без проверки на бота. - По желанию добавьте подсказки для обнаружения из v2:
<link rel="describedby" href="/llms.txt?lang=ru">в head страниц или заголовокLink: </llms.txt>; rel="describedby". На страницах с Markdown-копиями добавьтеrel="alternate" type="text/markdown". - Проверьте файл. Дайте его ChatGPT или Claude и спросите: «Что это за бизнес? Сколько стоят услуги? Когда открыто?» Похожую проверку предлагает и само предложение.
Шаблон llms.txt для сервисного бизнеса
Условный пример: сантехническая служба «Чистый поток» в Алматы. Компания, цены и адреса ниже вымышлены и нужны только для того, чтобы показать структуру:
# Чистый поток — сантехнические услуги в Алматы


> Ремонт и установка сантехники в Алматы и пригородах. Работаем с понедельника по субботу с 8:00 до 20:00. Аварийный выезд — круглосуточно.


«Чистый поток» обслуживает квартиры, частные дома и небольшие компании. Ниже указаны цены «от»; итоговая стоимость определяется после выезда мастера.


## Услуги и цены


- [Аварийный ремонт](https://www.example.com/services/emergency.md): выезд от 10 000 ₸, круглосуточно

- [Установка водонагревателя](https://www.example.com/services/water-heaters.md): от 25 000 ₸, демонтаж старого включён

- [Прочистка канализации](https://www.example.com/services/drains.md): от 12 000 ₸


## Контакты и часы работы


- [Контакты и запись](https://www.example.com/contact.md): телефон, WhatsApp, онлайн-запись, точка в 2GIS

- [Зона обслуживания](https://www.example.com/service-area.md): районы Алматы и пригороды


## Условия


- [Гарантия](https://www.example.com/warranty.md): 12 месяцев на детали и работу

- [Оплата и отмена](https://www.example.com/payment.md): наличные, карта, Kaspi QR; условия отмены


## Optional


- [Советы по обслуживанию](https://www.example.com/blog.md): сезонные рекомендации для владельцев жилья
Нужен ли ещё llms-full.txt?
llms-full.txt — отдельная договорённость: вся документация, собранная в один Markdown-файл. В текст предложения v2 он не входит, хотя сайты с документацией его часто используют. Например, Anthropic отдаёт и docs.anthropic.com/llms.txt, и /llms-full.txt.
Для сайтов с документацией мы рекомендуем оба файла. Большинству маркетинговых и сервисных сайтов хватит короткой карты.
Как проверить, запрашивают ли ИИ-боты ваш llms.txt
Добавить файл — самое простое. Проверка того, читает ли его кто-нибудь, подскажет, стоит ли тратить на него больше времени.
Вариант 1: логи сервера или CDN. Найдите в журналах доступа запросы к файлу и отфильтруйте их по user agent ИИ-ботов:
grep "llms.txt" access.log | grep -Ei "gptbot|oai-searchbot|chatgpt-user|claudebot|claude-user|perplexitybot|perplexity-user"
Затем проверьте IP-адреса: user agent может подделать кто угодно. OpenAI публикует диапазоны IP своих краулеров по адресам openai.com/searchbot.json и openai.com/gptbot.json, как описано в её документации о краулерах. Раз уж вы открыли логи, посмотрите заодно, какие обычные страницы запрашивают эти боты и какие коды ответа получают.
Вариант 2: Pulse. Pulse от Chetver показывает, какие боты ChatGPT, Claude, Gemini и других сервисов заходят на сайт, что они читают и где спотыкаются. К каждой проблеме прилагается совет, что изменить. На тарифе Pro Pulse показывает, какие ИИ-боты читают какие страницы и где сталкиваются с ошибками. Так видно, есть ли /llms.txt среди запрашиваемых URL и не отдают ли ошибки ваши ключевые страницы.
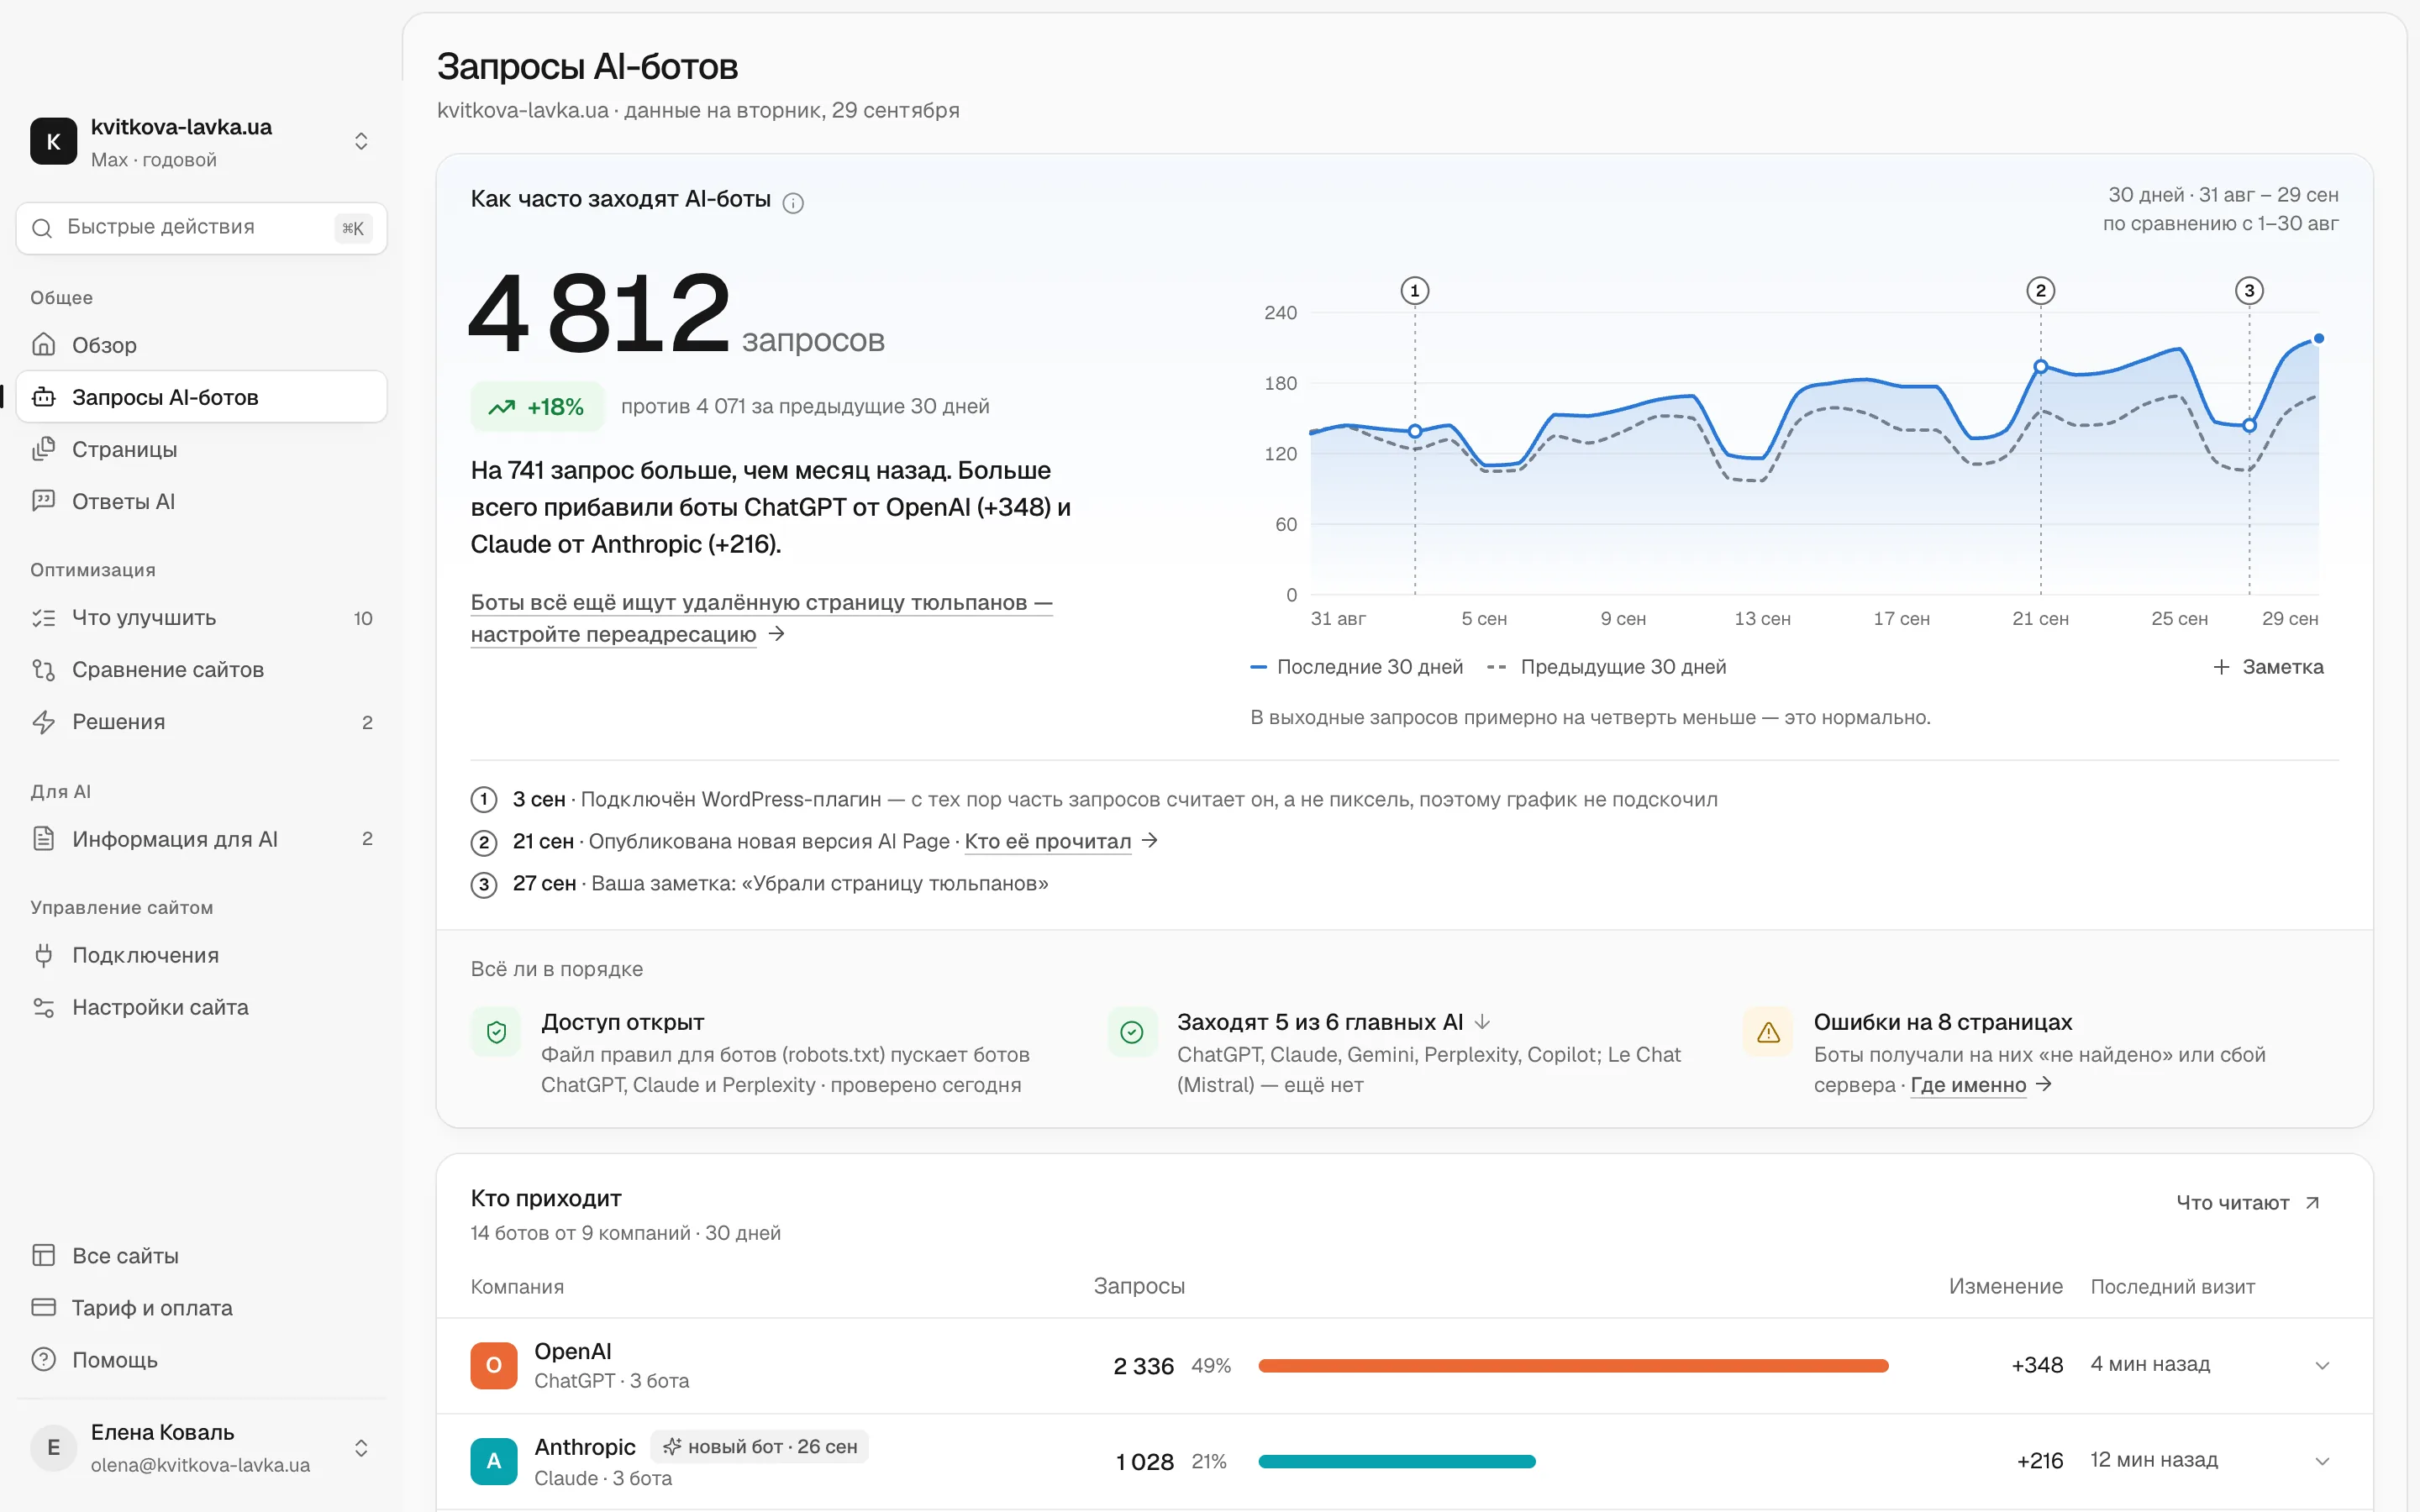
Если файл никто не запрашивает, ничего не сломано: это совпадает с исследованиями логов выше. Оставьте файл, поддерживайте его в актуальном состоянии и вложите силы в страницы, которые боты действительно читают: они должны отдавать 200, открываться без проверок и называть ваши факты простым текстом.
Какое место здесь занимает AI Page от Chetver
AI Page — одна страница с фактами о вашем бизнесе для ChatGPT, Claude и других ИИ-ассистентов: цены, часы работы, контакты и услуги. Сервис Chetver собирает её по вашему сайту, а вы публикуете её на aipage.yoursite.com. Вместе с ней идёт файл llms.txt, так что писать его вручную не придётся.
К AI Page относится та же оговорка, что и к llms.txt: никакой файл или страница не гарантирует упоминаний в ответах ИИ. Их ценность в том, что ваши факты собраны в одном чистом, правильном и удобном для чтения месте. Более широкая картина — llms.txt, директивы robots.txt и другие сигналы для ИИ-краулеров — в нашем исследовании сигналов для ИИ-краулеров в 2026 году.
Чек-лист по llms.txt на 10 минут
- Откройте
yoursite.com/llms.txt: возможно, платформа уже создала файл. - Сначала проверьте robots.txt: GPTBot, OAI-SearchBot, ClaudeBot и PerplexityBot не должны быть заблокированы случайно.
- Убедитесь, что на ключевых страницах простым текстом указаны цены, часы работы, адреса и контакты.
- Напишите или исправьте H1 и однострочное описание в цитате.
- Перечислите 5–20 ключевых страниц в разделах H2, у каждой — короткое фактическое пояснение.
- Пройдите по каждой ссылке и убедитесь, что она возвращает 200.
- Проверьте, что файл отдаётся как текст со статусом 200, без редиректа и проверки на бота.
- По желанию добавьте
rel="describedby"со ссылкой на/llms.txt. - Вставьте файл в ChatGPT или Claude и спросите, чем занимается ваш бизнес и сколько стоят услуги.
- Поставьте ежемесячное напоминание: обновлять файл при изменении цен, часов работы или услуг и смотреть логи на предмет запросов.
Следующий шаг: прежде чем править llms.txt, потратьте пять минут на второй пункт этого списка. Краулер, который не может попасть на сайт, не прочитает ни один опубликованный вами файл. Когда с доступом и фактами всё в порядке, llms.txt — быстрый и безвредный последний штрих. Чтобы узнать, как ИИ-ассистенты описывают ваш бизнес сейчас и что сделать, чтобы они называли вас, пройдите бесплатную проверку в ИИ.
Частые вопросы
Читает ли ChatGPT файл llms.txt?
Публичной документации об этом нет. Документация OpenAI о краулерах описывает OAI-SearchBot и GPTBot и то, как управлять ими в robots.txt, — роли для llms.txt там нет. OpenAI публикует llms.txt для собственной документации для разработчиков, но это не значит, что ChatGPT читает ваш.
Использует ли Google llms.txt для AI Overviews или AI Mode?
Нет. Джон Мюллер из Google неоднократно говорил, что Google не использует llms.txt. Согласно пересказам рекомендаций Google 2026 года по ИИ-функциям Поиска, llms.txt не нужен для появления в AI Overviews или AI Mode, а его наличие не влияет на позиции ни в плюс, ни в минус.
llms.txt — это официальный стандарт, как robots.txt?
Нет. llms.txt — предложение сообщества от Джереми Говарда из Answer.AI, впервые опубликованное в сентябре 2024 года; версия 2 вышла в августе 2026 года. robots.txt — стандарт IETF (RFC 9309).
Можно ли через llms.txt закрыть сайт от ИИ-краулеров или обучения ИИ?
Нет. llms.txt только перечисляет страницы и не управляет доступом. Чтобы разрешить или запретить обход краулерам вроде GPTBot, OAI-SearchBot, ClaudeBot или PerplexityBot, используйте robots.txt.
Может ли llms.txt навредить SEO?
Согласно пересказам рекомендаций Google 2026 года, наличие llms.txt не влияет на позиции ни в плюс, ни в минус. Практический риск — устаревшие данные, например старые цены или битые ссылки, поэтому обновляйте файл каждый раз, когда меняются ваши факты.
Чем llms.txt отличается от llms-full.txt?
llms.txt — короткая Markdown-карта ключевых страниц. llms-full.txt — отдельная договорённость, при которой вся документация собрана в один файл; в текст предложения llms.txt v2 он не входит. Сайты с документацией часто публикуют оба файла, а большинству сайтов бизнеса достаточно короткой карты.