Чтобы отслеживать трафик AI-ботов, нужны логи сервера (access logs) или логи CDN, отфильтрованные по user agent: GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, Claude-User, PerplexityBot. GA4 эту задачу не решает. Он фиксирует людей, которые перешли на сайт из ответа AI, но не сам AI, который прочитал ваш сайт, чтобы этот ответ составить.
Я считаю, что большинство компаний судит о своей видимости в AI по не тому отчёту. Вместо строки с рефералом chatgpt.com я бы смотрел на три цифры: какие AI-боты запрашивают какие страницы, какие коды ответа они получают и появляются ли вообще фетчеры, которые запускает пользователь.
Почему отчёт GA4 об «AI-трафике» показывает лишь малую часть
GA4 работает через JavaScript-тег, который выполняется в браузере посетителя. AI-краулеры обычно скачивают HTML и ваши скрипты не запускают. Анализ сети Vercel за декабрь 2024 года показал: крупные AI-краулеры скачивают JavaScript-файлы, но не выполняют их. Скрипт не запустился, значит, и тег не сработал.
Кроме того, Google отсеивает ботов намеренно. GA4 автоматически исключает трафик известных ботов и пауков. Отключить это нельзя, и сколько трафика отсеяно, тоже не видно. Так что даже бот, который выполнил тег, в отчёты не попадёт.
Остаются переходы с chatgpt.com, perplexity.ai и похожих сайтов. Каждый такой визит — это человек, который уже получил ответ и решил кликнуть. Но многие ответы заканчиваются без клика.
Условный пример: стоматология в Алматы. ChatGPT читает её страницу с ценами и рассказывает пользователю, сколько стоит профосмотр. Пользователь сразу звонит в клинику или пишет в WhatsApp. Визит, который на самом деле сработал, в GA4 не появится, хотя ответ взят со страницы самой клиники.
Что видит каждый инструмент
| Инструмент | Что фиксирует | Что упускает |
|---|---|---|
| GA4 | Сессии людей, в том числе переходы из AI-ассистентов | Краулеров и фетчеров. Известные боты исключаются по умолчанию |
| Clarity Agent Activity | Сессии, где AI-агент управляет настоящим браузером и тег срабатывает | Краулеров, которые только скачивают HTML; агентов от операторов, которых Clarity не распознаёт |
| Clarity AI Bot Activity | Как AI-краулеры и другие боты обращаются к вашему контенту (настраивается отдельно) | Охват зависит от настройки; уточняйте в документации Microsoft |
| Логи сервера | Каждый запрос: IP, URL, код ответа, user agent | Запросы, на которые CDN ответил из кеша |
| Логи CDN | Каждый запрос на уровне CDN, включая ответы из кеша и блокировки файрвола | По запросам ничего, но на некоторых тарифах логи хранятся недолго |
Microsoft Clarity выделила AI-агентов в отдельную категорию аналитики
Самый наглядный признак того, что рынок изменился, появился в этом месяце. 4 ноября 2026 года Microsoft анонсировала Agentic Analytics в Clarity, а MarketingProfs написал об этом в обзоре от 6 ноября. Дашборд Agent Activity показывает, какие агенты заходят на сайт и что там делают: ищут, отправляют формы, входят в аккаунт, скачивают файлы, записываются на приём, оформляют заказ. По словам Microsoft, число сессий агентов в неделю почти удвоилось за три недели и достигло почти 2 млн. Это данные самой Clarity, а не всего интернета.
Есть ограничения. Пока Clarity распознаёт агентов только трёх операторов: OpenAI, Google и Anthropic. В исследовании Microsoft от 29 октября агенты доходили до оформления заказа чаще людей. Но Microsoft сама предупреждает, что в эти сессии могли попасть случаи, когда агент передавал управление человеку. А PPC Land нашёл арифметическую нестыковку в процентах, как сообщил Relevant Audience. Я бы не стал строить планы на этих цифрах.
Для краулеров в Clarity есть отдельный дашборд AI Bot Activity в разделе Dashboards → AI Visibility. Настраивается он в Settings → AI Visibility; что нужно именно вашему сайту, смотрите в документации Microsoft. Метрика «AI crawl request share» показывает долю запросов страниц, которые приходятся на AI-ботов.
Получается, что Microsoft считает людей, агентов и краулеров по отдельности. Думаю, в ваших отчётах стоит делать так же.
Три цифры, которые я бы измерял вместо переходов
1. Какие AI-боты запрашивают какие страницы
Начните с охвата. Доходят ли боты до страниц с ценами, услугами, графиком работы и контактами? Или тратят визиты на главную и старые записи в блоге? AI нужны чёткие и конкретные факты о вашем бизнесе. Если боты не запрашивают страницы с этими фактами, это первый пробел, который стоит закрыть.
2. Какие коды ответа они получают
Код ответа — это трёхзначное число, которым сервер отвечает на каждый запрос. 200 — всё в порядке, 301 — страница переехала, 404 — не найдена, 5xx — ошибка сервера. В том же декабрьском анализе 2024 года Vercel сообщил, что краулеры ChatGPT и Claude тратили примерно треть запросов на страницы с ошибкой 404.
Ищите 404, ошибки 5xx, блокировки 403 от файрвола и цепочки редиректов. И проблему потише: ответ 200 на странице, которая собирается только через JavaScript. Бот получает пустую оболочку вместо вашего контента.
3. Появляются ли ChatGPT-User и Claude-User
Это фетчеры, которые запускает пользователь. Они заходят на страницу, потому что кто-то только что задал вопрос ChatGPT или Claude. Из всего, что есть в логах, это самый близкий признак того, что ответ строится на материалах вашего сайта.
Но это сигнал, а не доказательство: запрос ещё не значит, что ваш бизнес назвали в ответе. Поэтому я дополняю его отслеживанием того, что AI на самом деле о вас говорит. Об этом ниже.
Обучение, поиск или запрос пользователя: как различать AI-ботов
| Оператор | User agent | Назначение | robots.txt | Опубликованный список IP |
|---|---|---|---|---|
| OpenAI | GPTBot | Обучение | Соблюдает | gptbot.json |
| OpenAI | OAI-SearchBot | Поиск в ChatGPT | Соблюдает | searchbot.json |
| OpenAI | ChatGPT-User | Действия пользователя | Может не применяться | chatgpt-user.json |
| Anthropic | ClaudeBot | Обучение | Соблюдает | Не подтверждено; смотрите справку Anthropic |
| Anthropic | Claude-SearchBot | Качество поиска | Соблюдает | Не подтверждено; смотрите справку Anthropic |
| Anthropic | Claude-User | Вопросы пользователей | Соблюдает | Не подтверждено; смотрите справку Anthropic |
| Perplexity | PerplexityBot | Результаты поиска | Соблюдает | Да |
| Perplexity | Perplexity-User | Действия пользователя | Как правило, игнорирует | Да |
Источники: OpenAI, Anthropic, Perplexity. У Google всё устроено иначе. Google-Extended — это только токен для robots.txt без собственного user agent, поэтому отдельной строкой в логах он не появляется.
Как отследить AI-ботов в логах сервера: пошагово
- Найдите логи. В nginx они обычно лежат в
/var/log/nginx/access.log. В Apache смотрите/var/log/apache2/или/var/log/httpd/. На виртуальном хостинге ищите их в панели управления. В CDN — в настройках экспорта логов или аналитики. - Сохраните строки AI-ботов в отдельный файл:
grep -iE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User" access.log > ai-bots.log - Посчитайте страницы и коды ответа для одного бота:
grep -i "ChatGPT-User" ai-bots.log | awk '{print $9, $7}' | sort | uniq -c | sort -rn | head -20. В стандартном формате combined поле 9 — код ответа, поле 7 — URL. - Посмотрите распределение кодов ответа для всех AI-ботов:
awk '{print $9}' ai-bots.log | sort | uniq -c - Выгрузите список IP для проверки:
awk '{print $1}' ai-bots.log | sort | uniq -c | sort -rn - Сохраняйте такой срез каждую неделю, чтобы сравнивать состояние до и после каждого исправления.
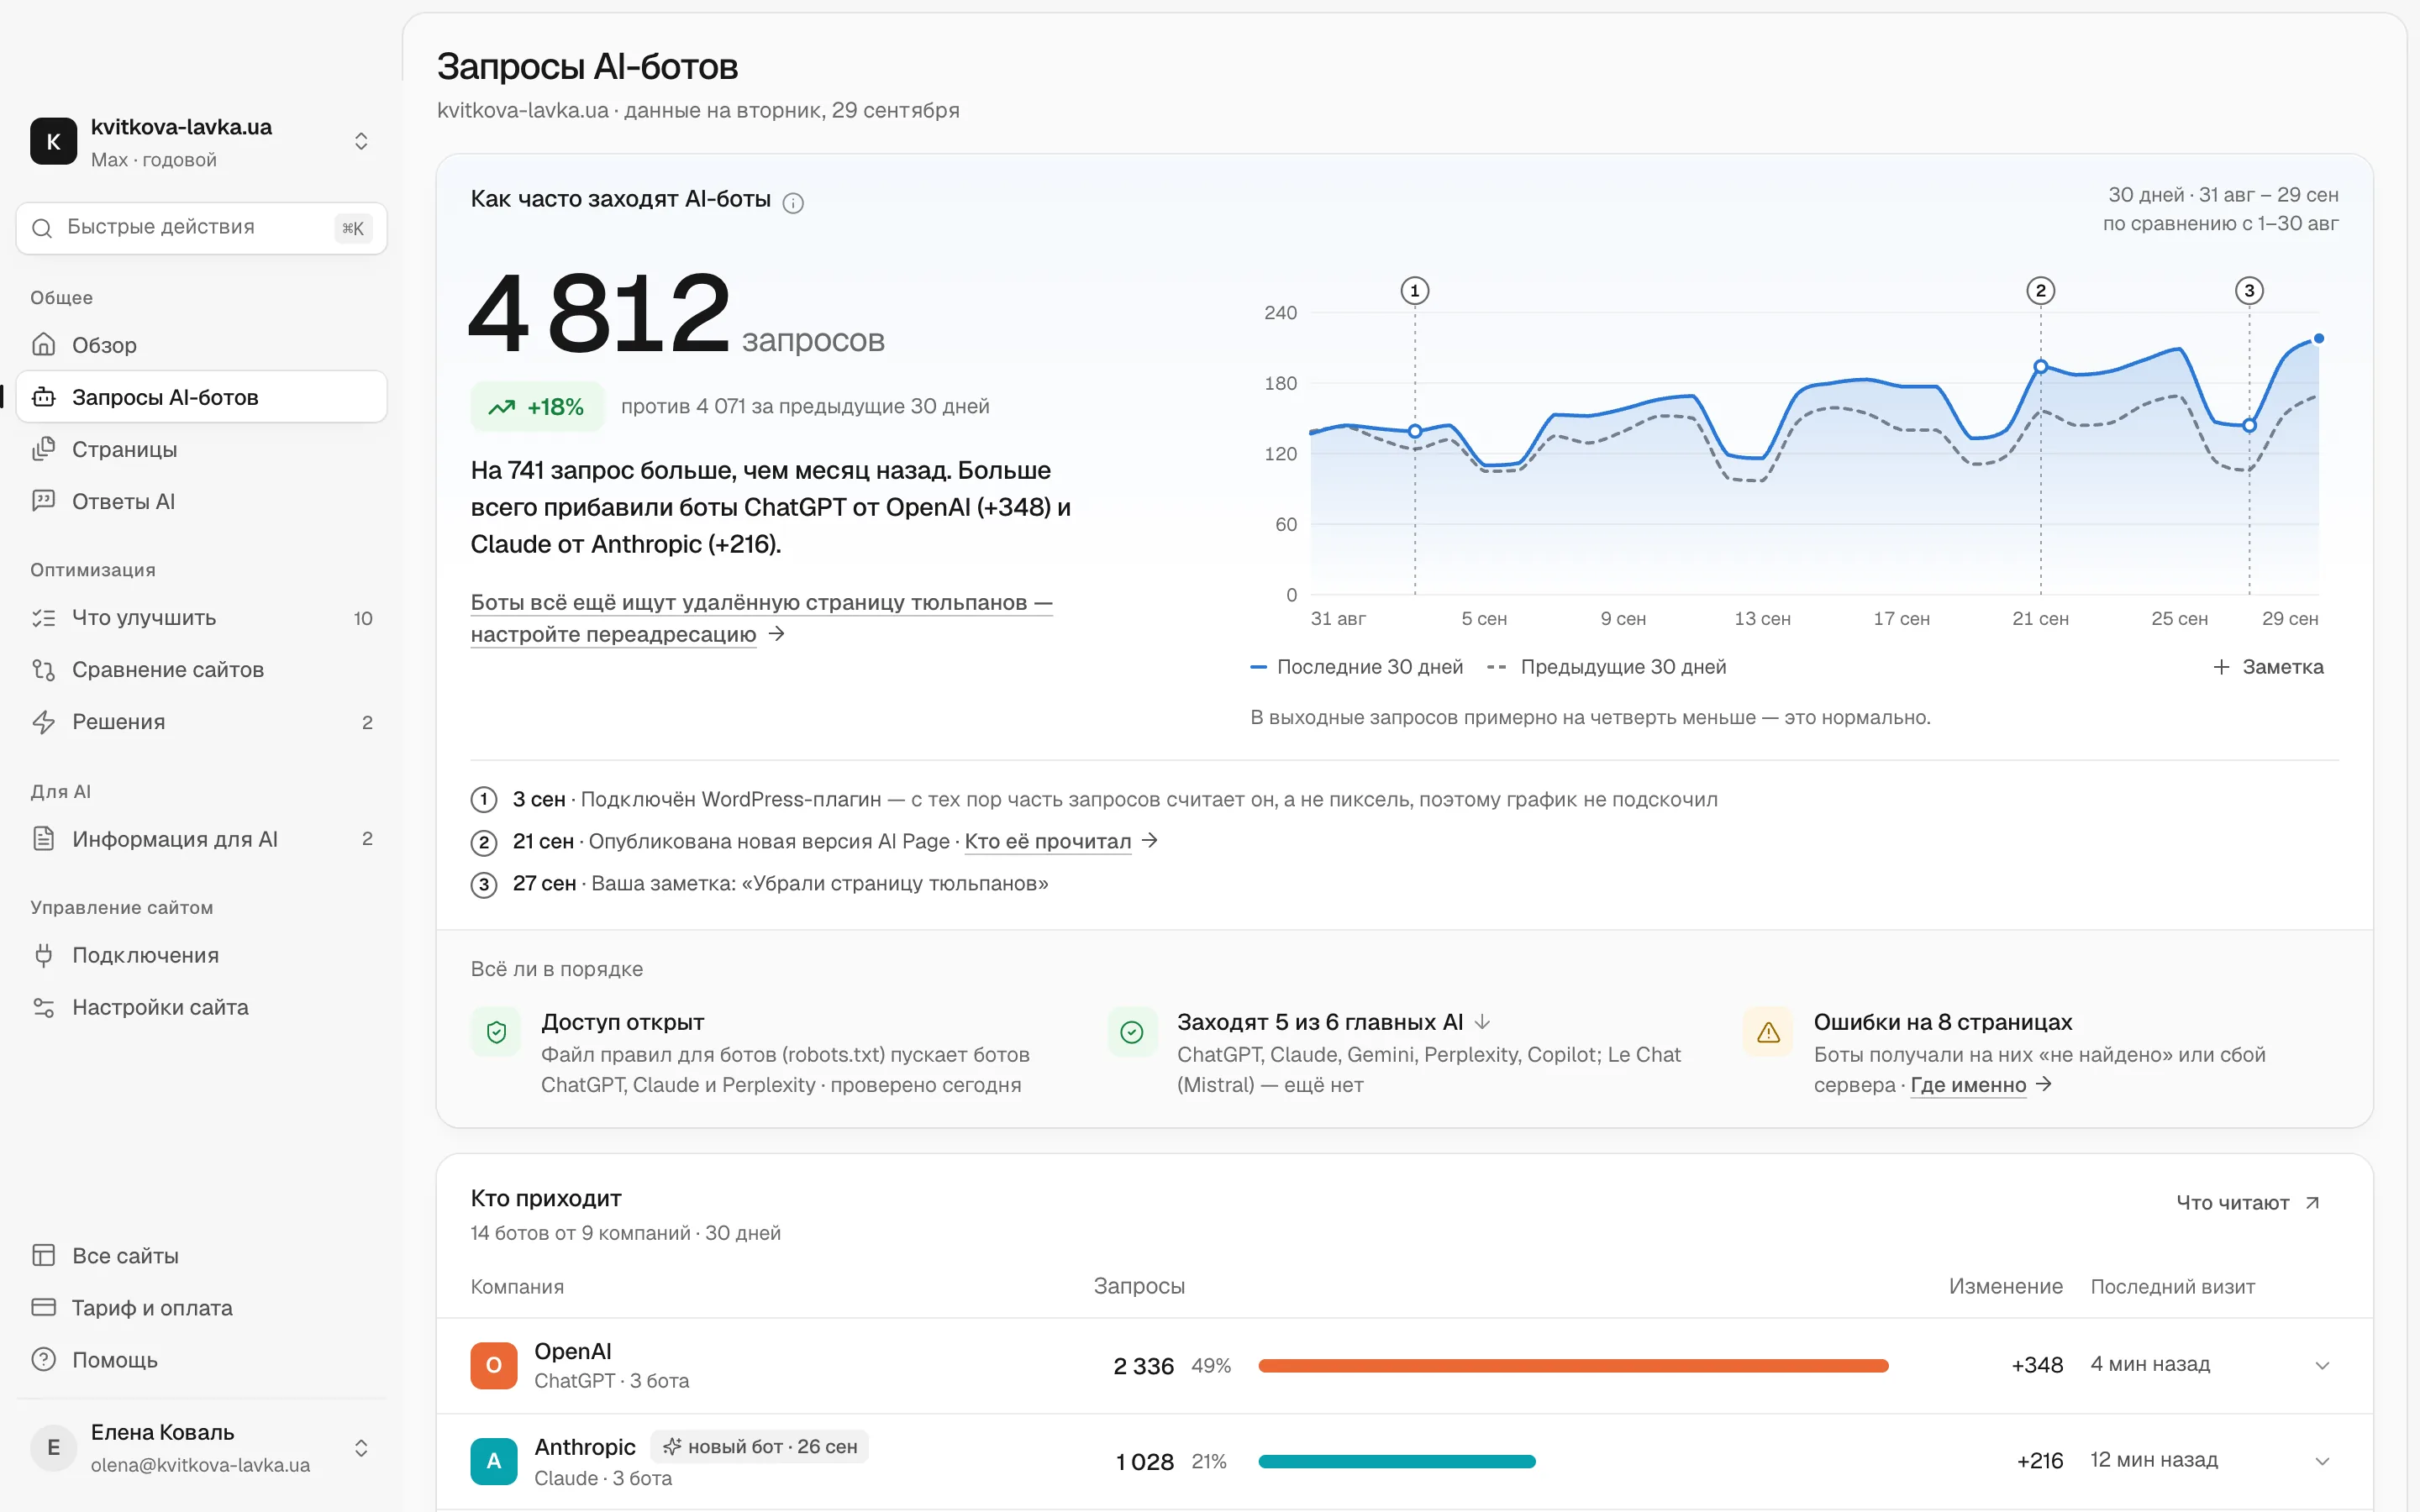
Если разбирать логи вручную не хочется, Pulse показывает, какие AI-боты заходят на ваш сайт, что читают и где натыкаются на ошибки. К каждой проблеме он даёт совет, что изменить.
Как проверить, что «GPTBot» в логах — действительно GPTBot
Строку user agent может скопировать кто угодно. Cloudflare сообщал о незаявленных краулерах, которые маскировались под обычные браузеры и меняли IP. Поэтому имя бота в логе — это заявление, а не доказательство.
- Списки IP. Сверяйте IP с JSON-файлами, которые публикуют OpenAI и Perplexity. Google тоже публикует свои списки.
- Обратный DNS. Для Google выполните обратный запрос по IP (например,
host 66.249.66.1). Убедитесь, что имя хоста заканчивается на googlebot.com, google.com или googleusercontent.com. Затем выполните прямой запрос по этому имени и проверьте, что он возвращает тот же IP. - Списка нет. Если оператор не публикует диапазоны IP, полностью проверить его ботов нельзя. Помечайте такие строки в отчётах как «заявленные», а не «проверенные».
- Подделки. Считайте их отдельно, чтобы они не раздували цифры. Если они создают нагрузку, блокируйте их на файрволе и проверьте, что правило не задевает настоящих ботов.
Что исправлять в первую очередь
- Ошибки 5xx, тайм-ауты и блокировки файрвола, на которые натыкаются проверенные AI-боты.
- 404 на тех URL, которые боты действительно запрашивают. Настройте редирект на актуальную страницу.
- Цепочки редиректов. Ведите каждый старый URL сразу на конечный адрес.
- Страницы, которые отдают пустую HTML-оболочку. Ключевые факты должны быть в HTML, который отправляет сервер, а не подгружаться потом скриптами.
- Правила robots.txt или настройки ботов в CDN, которые случайно блокируют поисковых ботов или фетчеры пользователей. Про robots.txt и другие сигналы подробно написано в исследовании Chetver о llms.txt и других сигналах для AI-краулеров в 2026 году.
Такие технические мелочи редко выглядят срочными. Но именно они незаметно отнимают у бизнеса упоминания в ответах AI.
Где переходам из AI всё же место в отчётах
GA4 не бросайте. Переходы — реальный результат, и они показывают, какие визиты из AI превращаются в заявки. Просто считайте их итогом, а не всей воронкой.
Логи показывают вход: что AI читает. Отслеживание упоминаний показывает выход: что AI говорит. Как измерять эту последнюю часть, объясняет исследование Chetver о Share of Model. Когда у вас есть все три источника, можно внести одно изменение и измерить его эффект, а не гадать.
Что я бы сделал на вашем месте
- На этой неделе выгрузите логи сервера или CDN за одну неделю и запустите grep из инструкции выше.
- Запишите три цифры: боты по страницам, коды ответа и как часто появляются ChatGPT-User и Claude-User.
- Проверьте IP за самыми крупными строками «AI-ботов» и отложите подделки в сторону.
- Исправляйте ошибки в порядке из списка выше, начиная с 5xx и блокировок на страницах с ценами и услугами.
- Через месяц сделайте такой же срез и сравните. Упоминания всё это не гарантирует. Это лишь убирает видимые препятствия, а их вы можете контролировать сами.
Частые вопросы
Может ли GA4 отслеживать визиты GPTBot или ClaudeBot?
Нет. GA4 работает через JavaScript-тег, который краулеры обычно не выполняют, а известных ботов Google исключает из GA4 автоматически. GA4 показывает только людей, которые перешли на сайт из ответов AI. Чтобы увидеть самих краулеров, нужны логи сервера или логи CDN.
Microsoft Clarity отслеживает AI-краулеров или только AI-агентов?
В Clarity два отдельных дашборда. Agent Activity показывает AI-агентов от OpenAI, Google и Anthropic, которые управляют настоящим браузером на вашем сайте. AI Bot Activity в разделе Dashboards → AI Visibility показывает, как краулеры обращаются к вашему контенту. Он настраивается отдельно в Settings → AI Visibility.
Если в логах есть ChatGPT-User, значит ли это, что ChatGPT упомянул мой бизнес?
Не обязательно. ChatGPT-User загружает страницу, когда она нужна для запроса пользователя, поэтому это самый близкий сигнал в логах, что ответ строится на материалах вашего сайта. Чтобы понять, назвали ли ваш бизнес на самом деле, отслеживайте сами ответы.
Выполняют ли AI-краулеры JavaScript?
По анализу сети Vercel за декабрь 2024 года, крупные AI-краулеры скачивают JavaScript-файлы, но не выполняют их. Контент, который появляется только после запуска скриптов в браузере, может быть для них невидим. Цены, услуги и контакты размещайте в HTML, который отправляет сервер.
Как понять, что запрос от GPTBot поддельный?
Сравните IP запроса с официальным списком OpenAI в файле gptbot.json. Для OAI-SearchBot и ChatGPT-User сделайте то же со своими файлами. Если IP в списке нет, считайте запрос непроверенным, что бы ни было написано в user agent. Если оператор не публикует список IP, помечайте его строки как заявленные, а не проверенные.