Чтобы отслеживать упоминания бренда в ChatGPT, Gemini, Perplexity и Claude, составьте 10–20 вопросов так, как их задают ваши клиенты. Задайте каждый вопрос несколько раз в чистой сессии. По каждому прогону записывайте, названы ли вы, на каком месте, рядом с какими конкурентами и со ссылкой на какие источники. Затем повторяйте тот же набор вопросов по тому же графику каждый месяц и смотрите на динамику, а не на отдельный ответ.
Сейчас хорошее время, чтобы зафиксировать отправную точку. Google начал выкатывать ноябрьское базовое обновление 2026 года и обновил Поиск на основе Gemini 4 Hydrogen. На той же неделе Seer Interactive опубликовала подробный повторный замер того, как часто ChatGPT упоминает её саму. Её метод стоит взять за образец. Ниже мы превращаем его в порядок работы, который можно выполнять без специальных инструментов.
Почему одна проверка в ChatGPT почти ничего не показывает
ChatGPT, Gemini, Perplexity и Claude каждый раз пишут ответ заново. Задайте один и тот же вопрос дважды — и можете получить другой список названий, в другом порядке, с другими источниками. Если вы один раз ввели вопрос и увидели свой бренд (или не увидели), у вас одна выборка, а не измерение.
Цифры Seer Interactive показывают, насколько велик бывает разброс. В феврале 2025 года Уил Рейнольдс задал ChatGPT три запроса по одному разу. ChatGPT назвал 21 агентство и ни разу не назвал Seer. В ноябре 2026 года Seer прогнала те же три запроса по 10 раз на трёх актуальных моделях ChatGPT с включённым веб-поиском: всего 90 прогонов. Seer была названа в 58 из них, примерно в 64% (в заголовке статьи это округлено до 65%).
Цифры по отдельным вопросам важнее общей суммы. Seer появилась в 25 из 30 ответов на запрос про «PPC and SEO agency» и в 28 из 30 — на запрос про «data-driven SEO companies», но лишь в 5 из 30 — на запрос про «innovative SEO agency». Один бренд, одна неделя: от «почти всегда» до «редко» — в зависимости от формулировки вопроса.
Seer сама перечисляет ограничения своего сравнения. Замер 2025 года — это один прогон в ChatGPT под учётной записью на GPT-4o. Прогоны 2026 года шли через API без памяти и персонализации, на более новых моделях. И изменения нельзя напрямую привязать к конкретным действиям. Вывод для вас: зафиксируйте условия проверки с первого дня и задавайте каждый вопрос больше одного раза.
Как отслеживать упоминания бренда в ChatGPT: пять шагов
Порядок работы состоит из пяти шагов. Вам понадобятся таблица, бесплатные или платные версии четырёх ассистентов и постоянное время в календаре каждый месяц.
- Составьте 10–20 тестовых вопросов так, как их задают клиенты.
- Задайте каждый вопрос несколько раз в чистой сессии в каждом ассистенте.
- Запишите каждый прогон в одну таблицу.
- Сведите журнал к показателю Share of Model.
- Повторяйте по постоянному ежемесячному графику и отмечайте внешние события.
Шаг 1. Составьте 10–20 вопросов так, как их задают клиенты
Тестовые вопросы должны звучать как слова реальных покупателей, а не как ваши рекламные тексты. Берите формулировки из звонков в отдел продаж, писем в поддержку, отзывов и запросов в Google Search Console. Охватите пять типов вопросов:
| Тип вопроса | Что он проверяет | Шаблон |
|---|---|---|
| Категория | Попадаете ли вы в стандартный ответ по своей сфере | «Какой [категория] выбрать для [задача]?» |
| Локальный | Появляетесь ли вы в ответах по своему городу | «Лучший [услуга] в [город]» |
| Сравнение | Как вас описывают рядом с конкурентом | «[Вы] или [конкурент]: что лучше для [потребность]?» |
| Альтернативы | Предлагают ли вас как вариант для перехода | «Альтернативы [конкурент]» |
| От проблемы | Вспоминают ли о вас, когда покупатель называет потребность, а не категорию | «Как [решить проблему] без [боль]?» |
Условный пример: стоматологическая клиника в Алматы. Её набор может включать «лучшая стоматология в Алматы», «клиника в Алматы для установки имплантов», «[Клиника] или [клиника-конкурент]: что выбрать», «альтернативы [клиника-конкурент]» и «как вылечить зуб без боли, если боюсь стоматологов». В большинстве вопросов не должно быть названия вашего бренда: они проверяют, находит ли вас ассистент сам. Добавьте два-три брендовых вопроса («Сколько стоит консультация в [Клиника]?») отдельной группой. Они проверяют не то, находят ли вас, а то, верны ли факты.
Присвойте каждому вопросу номер (Q01, Q02…) и больше никогда не меняйте формулировку. Если нужен новый вопрос, добавьте его под новым номером и начните его историю с нуля.
Шаг 2. Задайте каждый вопрос несколько раз в чистой сессии
Ваша история переписки, память ассистента и местоположение могут влиять на ответ. Чистые и повторяемые условия делают цифры этого месяца сопоставимыми с цифрами следующего.
- Используйте чистую сессию. Выйдите из учётной записи или откройте временный чат либо режим инкогнито с отключёнными памятью и персонализацией, если ассистент это позволяет.
- Для каждого прогона начинайте новый чат. Вставляйте точную формулировку. Никаких уточняющих вопросов и никаких «а что насчёт нас?».
- Где можно, оставляйте веб-поиск включённым и отмечайте, использовался ли он. Seer проводила тесты с включённым веб-поиском, поэтому её цифры отражают ответы, которые могли опираться на актуальные веб-страницы.
- Задавайте каждый вопрос 3–5 раз в каждом ассистенте. Seer делала по 10 прогонов на запрос для каждой модели. Чем больше прогонов, тем устойчивее цифра, поэтому для действительно важных вопросов делайте больше.
- Записывайте модель, дату и местоположение. Укажите название модели, если интерфейс его показывает, и страну, из которой вы проверяли. Локальные ответы зависят от местоположения, поэтому не меняйте VPN от месяца к месяцу.
Выберите один способ и придерживайтесь его: либо обычные приложения, либо API. API — это интерфейс для разработчиков, который отправляет вопросы модели напрямую, без памяти и настроек учётной записи из приложения. Оговорка Seer показывает, что ответы в приложении под учётной записью и через API могут не совпадать, поэтому смешивание двух способов размывает динамику.
Шаг 3. Записывайте каждый прогон в одну таблицу
Одна строка — один прогон. Этот шаблон покрывает всё, что понадобится и для расчётов, и для поиска пробелов позже:
| Столбец | Что записывать | Пример заполнения |
|---|---|---|
| Дата | День прогона | [ГГГГ-ММ-ДД] |
| Ассистент и модель | Продукт и название модели, если оно видно | ChatGPT, [модель] |
| Номер вопроса | Из вашего зафиксированного списка | Q04 |
| № прогона | 1, 2, 3… | 2 |
| Названы? | Да / Нет | Да |
| Место | Позиция в списке или «единственное упоминание» | [3-е из 6] |
| Названные конкуренты | Все остальные бренды в ответе | [Конкурент А], [Конкурент Б] |
| Источники | URL, на которые сослался ассистент | [URL подборки], [ваша главная страница] |
| Упоминает ли вас источник? | Да / Нет / Не проверено | Нет |
| Реклама или органика | Отметьте любое рекламное размещение | Органика |
| Факты верны? | Цены, адрес, услуги, часы работы | Неверные часы работы |
Два столбца требуют особого внимания. Источники: если ассистент показывает источники, копируйте URL. Это главная подсказка, когда вы будете искать пробелы. Реклама или органика: в ChatGPT теперь есть реклама, а в последнем обновлении ChatGPT Ads OpenAI добавила в Ads Manager интеллектуальное назначение ставок и новые целевые показатели стоимости. Никогда не засчитывайте платное размещение как органическое упоминание.
Шаг 4. Сведите журнал к показателю Share of Model
Share of Model — это доля ответов ИИ, в которых назван ваш бренд: аналог доли голоса (share of voice) для ИИ-ассистентов. Подробно мы разбираем эту модель в исследовании о том, как измерять Share of Model и видимость в ИИ. Для ежемесячной проверки достаточно таких показателей:
- Частота упоминаний = прогоны, где вас назвали ÷ все прогоны × 100.
- Частота упоминаний по ассистентам: та же формула отдельно для ChatGPT, Gemini, Perplexity и Claude.
- Частота упоминаний по типам вопросов: категория, локальный, сравнение, альтернативы, от проблемы.
- Доля конкурентов: та же формула для каждого конкурента из журнала.
- Среднее место — считается только по прогонам, где вас назвали.
Опубликованные цифры Seer подходят для наглядного расчёта. Seer: 58 ÷ 90 = 64%. Её конкурент iPullRank появился в 50 из 90 ответов, примерно в 56%. Но на запросе про «innovative SEO agency» iPullRank назвали в 23 из 30 прогонов, а Seer — в 5 из 30. Общая цифра скрыла бы этот разрыв.
Seer также делит бренды на группы по стабильности упоминаний, и их можно использовать у себя. Стабильно — назван минимум в 2 из 3 ответов. Редко — назван реже чем в 1 из 3. Иногда — всё, что между ними. Из 21 агентства, которые ChatGPT назвал в феврале 2025 года, в ноябре 2026 года, по данным Seer, ни одно не появлялось стабильно: 4 появлялись иногда, 8 — редко, 9 — ни разу.
Шаг 5. Повторяйте по постоянному графику каждый месяц
- Прогоняйте весь набор в одну и ту же неделю каждого месяца в тех же условиях.
- Записывайте внешние события в столбец «контекст» рядом с месяцем.
- Сравнивайте частоту упоминаний по ассистентам и типам вопросов с прошлым месяцем.
- Выберите один-два пробела для работы (см. следующий раздел) и записывайте дату каждого изменения на сайте или в карточках компании.
- В следующем месяце повторите прогоны и проверьте, сдвинулись ли целевые вопросы.
Для ноября 2026 года в столбце «контекст» уже есть несколько записей. Search Engine Roundtable сообщил о колебаниях позиций 8 и 9 ноября и о начале выкатки базового обновления. Google запустил в Поиске обновление на Gemini 4 Hydrogen через несколько дней после выхода Gemini 4 Carbon. Google также подтвердил ошибку логирования в отчёте Search Console об эффективности в генеративном ИИ за 9–11 ноября, из-за которой показы в отчёте занижены. Если сравниваете данные Google, отметьте эти даты как ненадёжные. Записывайте и смену моделей ChatGPT: модели, которые Seer тестировала в 2026 году, отличались от той, что использовалась в 2025-м.
Как читать пробелы в журнале
Цифры показывают, где вы находитесь. Столбцы с источниками и конкурентами объясняют почему.
Вас не называют совсем
Откройте источники, на которые ассистенты сослались по этому вопросу, и проверьте, упоминают ли они вас. Анализ Seer показывает, на что смотреть. В 58 ответах, где была названа Seer, ChatGPT в 21 случае ссылался на собственный сайт Seer (главную страницу и страницы /work). Остальные четыре самые цитируемые страницы — подборки «лучших агентств» на сайтах агентств, которые ставят на первое место самих себя. В двух из них Seer была в списке, на 4-м и 3-м местах, и все четыре обновлялись в последние несколько месяцев. Если страницы, на которых строится ответ, вас не упоминают, ассистенту не на что опереться.
Конкурентов называют по подборкам и каталогам
Составьте список всех сторонних страниц, где названы конкуренты, но нет вас: сайты отзывов, отраслевые каталоги и справочники (например, карточки в 2GIS), статьи «лучшие…», страницы сравнений. Это ваш список для переговоров и размещений. Просите включить вас в рассмотрение, обновляйте устаревшие профили и следите за точностью данных. Не пытайтесь создавать упоминания искусственно.
Вас называют, но с ошибками в фактах
Неверные цены, старый адрес или услуги, которых больше нет, указывают на ваш сайт и ваши карточки. Найдите, на какой из процитированных страниц устаревший факт. Затем убедитесь, что актуальные данные собраны на одной понятной и легко читаемой странице.
Могут ли ИИ-боты прочитать ваш сайт?
Если ваших страниц никогда нет среди источников, первым делом проверьте доступ. Посмотрите, не заблокированы ли в robots.txt, настройках ботов в CDN и правилах файрвола такие краулеры, как OAI-SearchBot (поиск ChatGPT), ClaudeBot (Anthropic) и PerplexityBot. В нашей карте llms.txt и других сигналов для ИИ-краулеров в 2026 году объясняется, как правила robots.txt сочетаются с остальными сигналами. Логи сервера покажут, приходят ли эти боты на самом деле и с какими ошибками сталкиваются. Pulse показывает то же самое на панели: какие ИИ-боты заходят на сайт, что читают и где спотыкаются.
Что меняет цифры: доступ ботов, страница с фактами и сторонние площадки
Измерять и исправлять — разные задачи. Общая картина — в нашем исследовании о том, как меняются правила видимости при переходе от SEO к GEO. GEO (generative engine optimization, оптимизация под генеративные системы) — это работа над тем, чтобы ИИ-ассистентам было легко найти ваш бизнес, понять его и сослаться на него. Вот рычаги, которые чаще всего объясняют пробел в журнале:
| Рычаг | Что проверить | Где смотреть |
|---|---|---|
| Доступ ботов | Поисковые ИИ-краулеры разрешены и не заблокированы правилами CDN или файрвола | robots.txt, настройки CDN, логи сервера |
| Ошибки на ключевых страницах | Боты получают ответ 200 на страницах услуг, цен и контактов, а не 403 или 5xx | Логи сервера, отчёты по ботам |
| Страница с фактами | Цены, часы работы, контакты и услуги актуальны и собраны в одном месте | Ваш сайт, AI Page, llms.txt |
| Ваши ключевые страницы | Главная, кейсы и страницы услуг ясно говорят, чем вы занимаетесь и для кого | Страницы, которые ассистенты цитируют о вас |
| Сторонние площадки | Вы есть в подборках, каталогах и на сайтах отзывов, которые цитируют ассистенты | Столбец «Источники» в вашем журнале |
Для страницы с фактами один из вариантов — AI Page от Chetver. Сервис Chetver собирает с вашего сайта страницу с ценами, часами работы, контактами и услугами, вы публикуете её на aipage.yoursite.com, и к ней прилагается файл llms.txt. Подробнее идея разобрана в нашем исследовании о GEO, AIEO и о том, зачем бизнесу AI Page. Что бы вы ни меняли, записывайте дату, чтобы цифры следующего месяца можно было сопоставить с этим изменением.
Реальный замер «до» и «после»: Sereda.ai
Кейс Sereda.ai показывает зафиксированный метод с чёткими датами. Sereda.ai — украинская HR-платформа. До появления AI Page ChatGPT говорил, что не знает этот продукт, а в списках HR-инструментов он почти не появлялся. AI Page опубликовали 22 октября 2025 года.
- Вопросов: 4.
- Оценка: 5 критериев × 10 баллов, приведено к 100 и усреднено по 4 вопросам. Два исследователя оценивали ответы независимо друг от друга.
- «До»: сентябрь — начало октября 2025 года. «После»: начало декабря 2025 года.
- Результат: ChatGPT 24 → 87, Gemini 28 → 91.
В кейсе каждый ответ оценивается по пяти критериям, а не считаются упоминания, так что это другой показатель, чем Share of Model. Но структура та же, что нужна вашей проверке: зафиксированные вопросы, зафиксированный метод оценки, изменение с датой и периоды замеров по обе стороны от него. Это один кейс, а не прогноз для любого другого бизнеса.
Когда стоит автоматизировать проверку
Ручная проверка ничего не стоит, кроме времени. При 15 вопросах, четырёх ассистентах и трёх прогонах на каждый это 180 прогонов в месяц, которые нужно ввести и записать. Мы рекомендуем первые месяц-два делать всё вручную: так вы поймёте, какие вопросы и источники важны. После этого автоматизация экономит время.
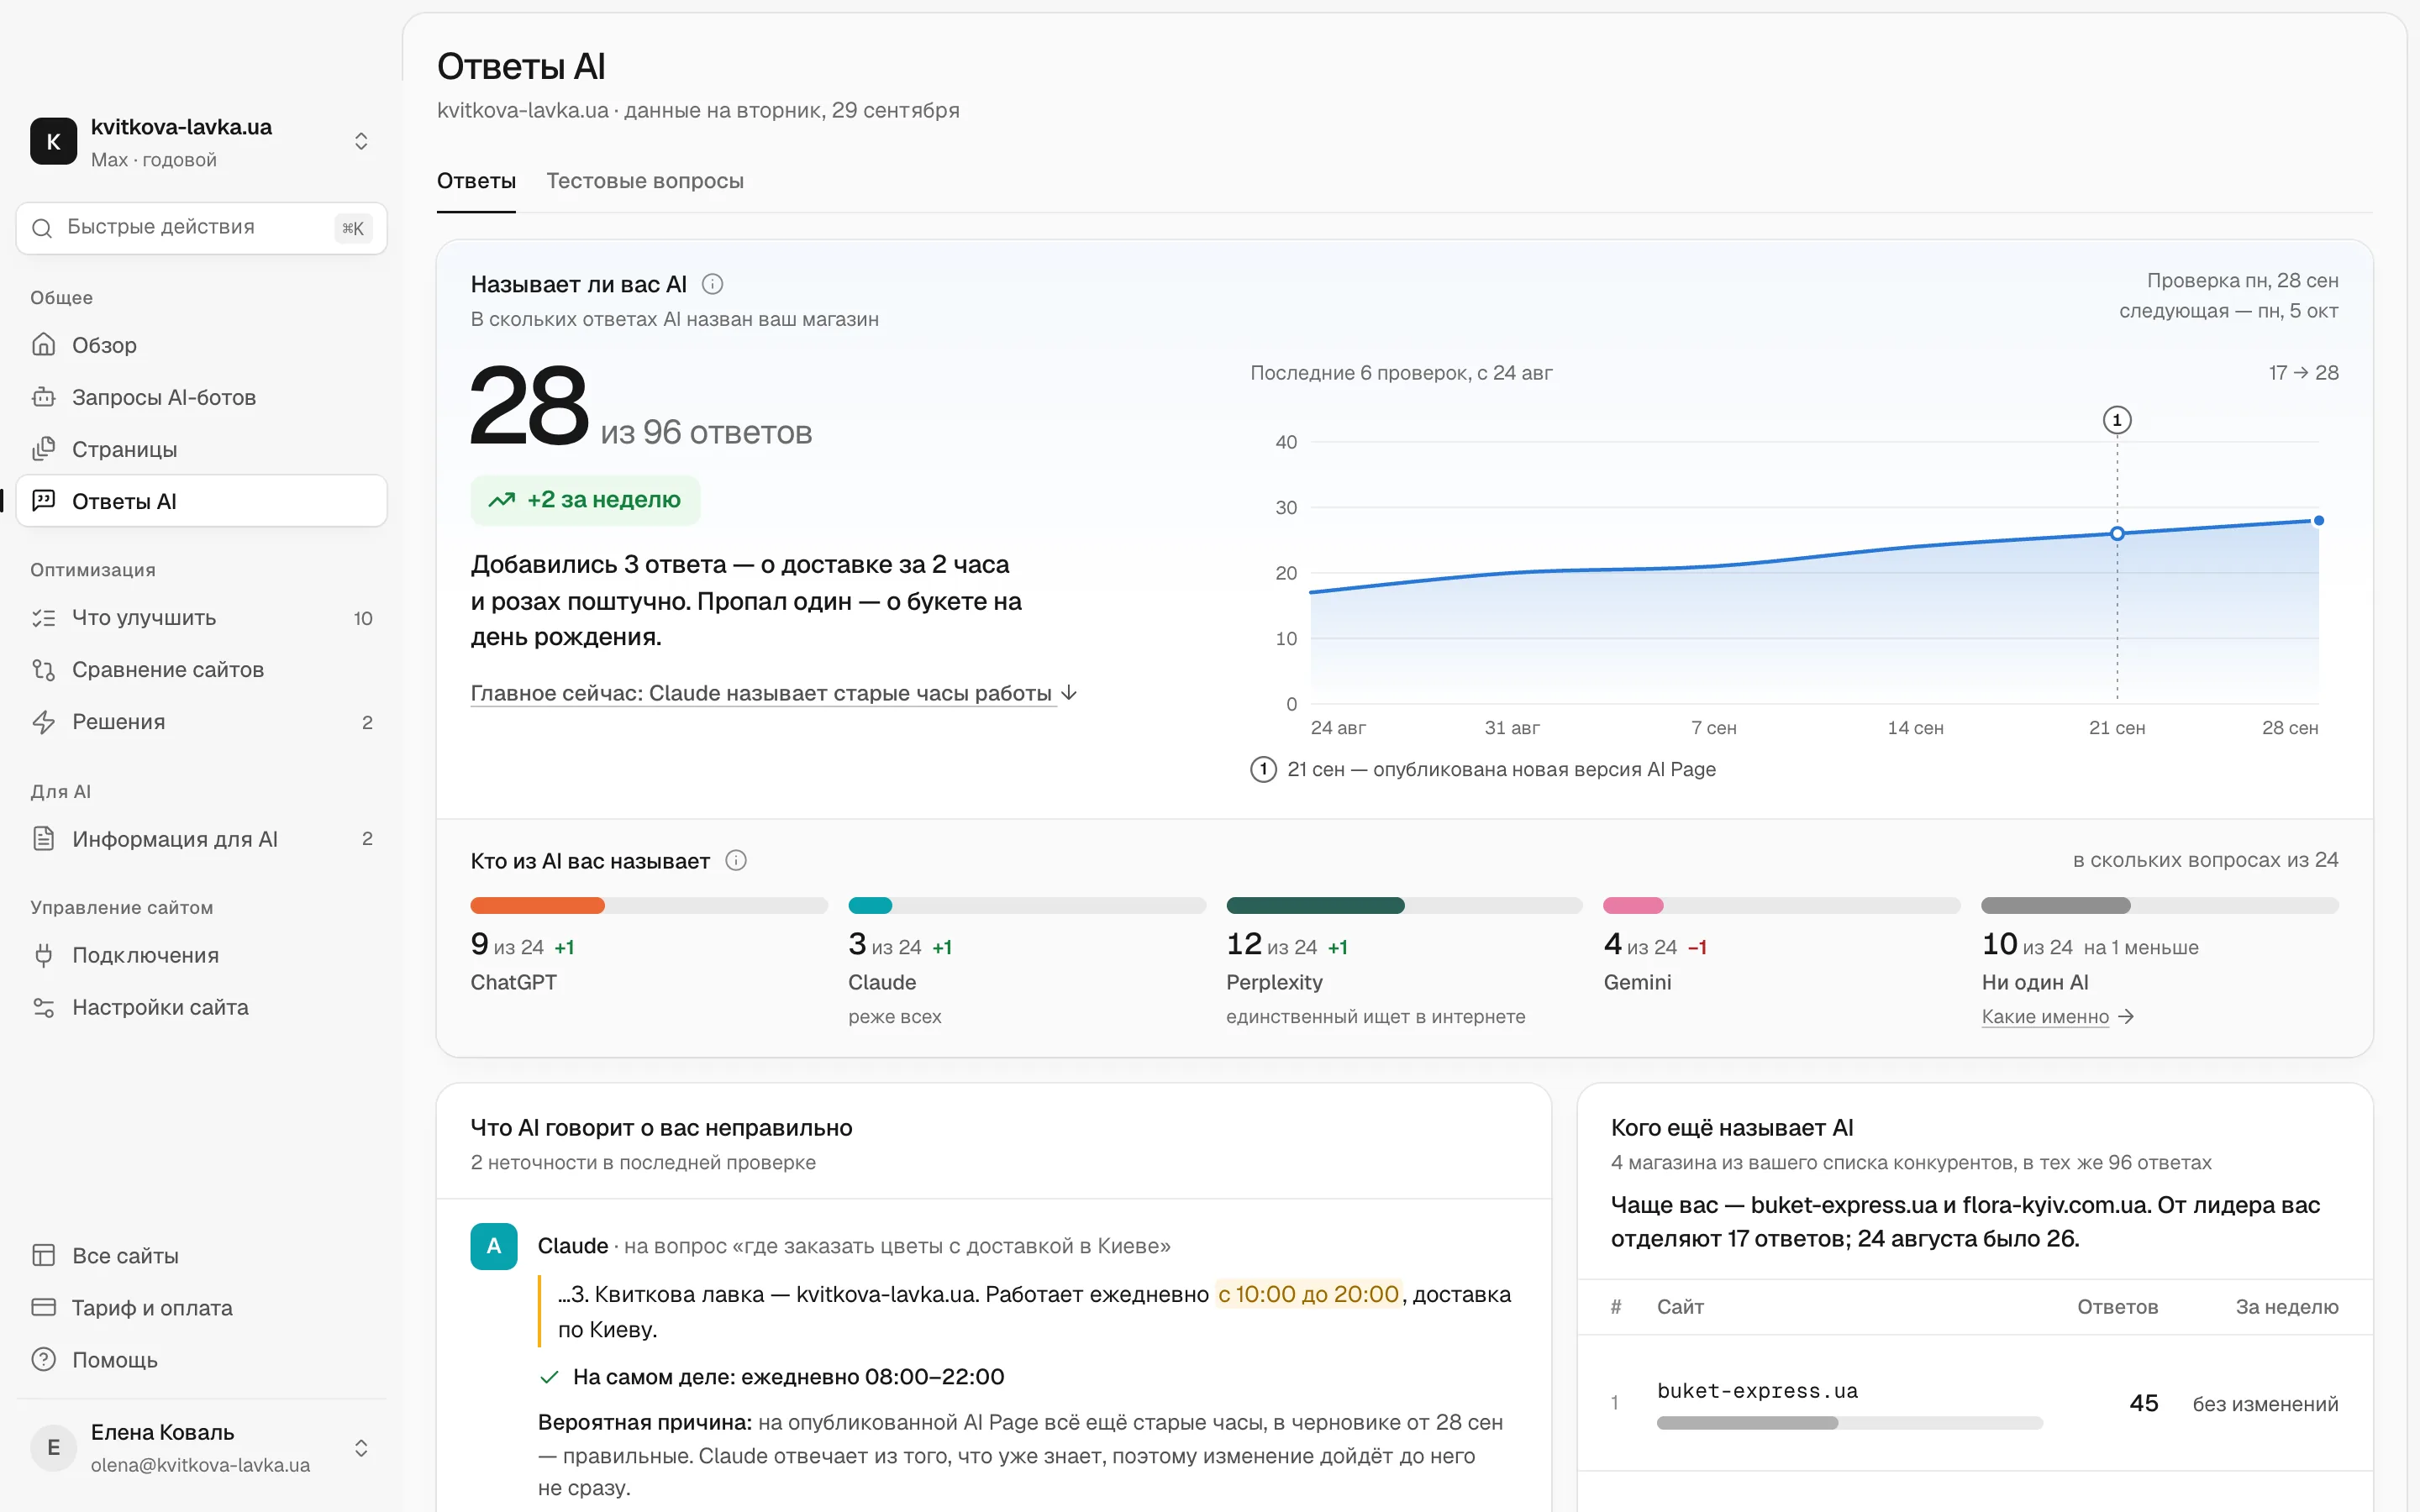
Для первого взгляда подойдёт бесплатная проверка в ИИ: она показывает, как ИИ видит ваш бизнес и что сделать, чтобы он называл вас, а не кого-то другого. Для регулярных замеров есть функция «Ответы ИИ» на тарифе Max ($99 в месяц за один сайт, см. тарифы): каждую неделю она задаёт ChatGPT, Claude, Perplexity и Gemini ваши тестовые вопросы и считает, сколько ответов вас упоминают. Тарифы Basic и Pro отвечают за сторону сайта: еженедельные проверки и оценку готовности к ИИ, а на Pro — ещё и то, какие ИИ-боты читают какие страницы и где сталкиваются с ошибками.
Отслеживайте бизнес-результаты рядом с упоминаниями: видимость — это ещё не выручка. Seer сообщает, что с ноября 2024 года по 22 октября 2026 года ИИ-ассистенты принесли ей 0,3% сеансов и 0,2% подписок на рассылку: 2359 сеансов и 9 подписок. Добавьте переходы из ИИ в отчёт по аналитике. Со стороны Google отделить такой трафик поможет новая справочная статья Google о том, как определять трафик из Google Поиска по HTTP-заголовку Referer, — о ней написано в том же обзоре.
Что сделать дальше
Регулярная проверка полезна, только если вопросы и условия не меняются от месяца к месяцу. На этой неделе составьте 10–20 вопросов с номерами, подготовьте таблицу по шаблону выше и сделайте первый замер до конца ноября. Отметьте в столбце «контекст» базовое обновление, запуск Gemini 4 Hydrogen и ошибку Search Console за 9–11 ноября. В следующем месяце прогоните тот же набор снова и разберите пробелы с учётом источников, на которые ссылался каждый ассистент.
Частые вопросы
ChatGPT всем отвечает одинаково, когда спрашивают про мой бренд?
Нет. Каждый ответ генерируется заново, поэтому на один и тот же вопрос от раза к разу могут называться разные бренды. На ответ также влияют память, история переписки и местоположение. Поэтому проверяйте в чистой сессии и задавайте каждый вопрос несколько раз.
Сколько раз задавать один вопрос, чтобы измерить упоминания в ИИ?
Начните с 3–5 прогонов на вопрос в каждом ассистенте, а для самых важных вопросов делайте больше. Seer Interactive в замере ноября 2026 года делала по 10 прогонов на запрос для каждой модели. Чем больше прогонов, тем устойчивее частота упоминаний.
Можно ли увидеть упоминания бренда в ответах ИИ через Google Search Console?
Только со стороны Google. В Search Console есть отчёт об эффективности в генеративном ИИ для ИИ-функций Google Поиска. ChatGPT, Claude и Perplexity он не охватывает. Google подтвердил ошибку логирования в этом отчёте за 9–11 ноября 2026 года, из-за которой показы занижены, поэтому отметьте эти даты как ненадёжные.
Считается ли реклама в ChatGPT упоминанием бренда?
Не при отслеживании органических упоминаний. В ChatGPT теперь есть реклама с вариантами назначения ставок в Ads Manager, поэтому отмечайте любое спонсорское размещение в отдельном столбце. Не включайте его в показатель Share of Model.
Можно ли бесплатно отслеживать упоминания бренда в ChatGPT?
Да. Зафиксированный набор тестовых вопросов, чистые сессии и журнал в таблице стоят только времени. Бесплатная проверка Chetver даёт первое представление о том, как ИИ видит ваш бизнес, а тариф Max автоматизирует еженедельные тестовые вопросы в ChatGPT, Claude, Perplexity и Gemini.