Robots.txt для ШІ-ботів налаштовують окремо для кожного бота: єдиного перемикача «ШІ» не існує. Щоб потрапляти у відповіді ChatGPT, Claude і Perplexity, дозвольте пошукових краулерів (OAI-SearchBot, Claude-SearchBot, PerplexityBot) і ботів, яких запускає користувач (ChatGPT-User, Claude-User, Perplexity-User). Заблокувати навчальних краулерів і токени на кшталт GPTBot, ClaudeBot, Google-Extended та Applebot-Extended — окреме рішення. OpenAI прямо пише, що кожне налаштування її краулерів не залежить від інших.
Robots.txt — це звичайний текстовий файл у корені сайту (вашсайт.com/robots.txt), який підказує краулерам, які сторінки їм можна завантажувати. 2 листопада 2026 року керівник споживчого продукту ChatGPT Адам Фрай заявив, що обсяг пошукових запитів у ChatGPT становить приблизно п'яту частину від Google. До цієї цифри варто ставитися обережно. За повідомленнями преси, OpenAI зараховує пошук тоді, коли запитання користувача запускає вебпошук, а абсолютного числа Фрай не назвав. У огляді MarketingProfs AI Update також зауважили, що OpenAI не вказала джерела для порівняння з Google.
Хай якою є точна частка, ChatGPT може показати ваші сторінки у відповідях, лише якщо до них дістанеться його пошуковий краулер. Цей посібник саме про технічний крок: як переконатися, що потрібні боти можуть зайти на сайт.
Чому сайти блокують ШІ-ботів, самі того не знаючи?
Блокування ChatGPT чи Claude часто ніхто свідомо не вмикав. Його спричиняє налаштування за замовчуванням, правило, скопійоване з іншого сайту, або інструмент безпеки. Насамперед перевірте ці чотири причини.
Перемикачі «блокувати ШІ-ботів» у CDN і на хостингу
CDN (мережа доставки контенту) — сервіс між вашим сервером і відвідувачами, який пришвидшує сайт і фільтрує трафік. 1 липня 2025 року Cloudflare оголосила, що за замовчуванням блокує відомих ШІ-краулерів для нових доменів. Власники можуть їх дозволити, а ще Cloudflare пропонує керований robots.txt.
Якщо ваш домен додали до Cloudflare після цієї дати або хтось клацнув опцію «блокувати ШІ», боти можуть зупинитися ще до того, як побачать ваш robots.txt. Відкрийте це налаштування й подивіться, яких ботів воно охоплює. Широкий перемикач «ШІ-боти» може зачепити не лише навчальних, а й пошукових краулерів. Пошукайте схожі опції в панелі хостингу та в інших CDN, якими користуєтеся.
Скопійовані правила і повна заборона Disallow
Деякі сайти досі віддають User-agent: * разом із Disallow: /. Часто це залишок від тестової версії сайту чи редизайну. Таке правило просить усіх краулерів, що дотримуються robots.txt, не заходити, зокрема й пошукових ШІ-краулерів. Інші сайти вставляють довгий список «заблокувати весь ШІ» з якогось блогу, не перевіривши, яких ботів він називає.
Правила файрвола, що відповідають ботам 403 або перевіркою
WAF (файрвол вебзастосунків) блокує трафік, схожий на автоматичний. Режими боротьби з ботами, ліміти запитів і блокування за країнами можуть віддавати ШІ-ботам 403 (доступ заборонено), 429 (забагато запитів) або сторінку з CAPTCHA. У robots.txt може стояти «дозволено», а бот однаково не отримає нічого, що можна прочитати.
Застарілі назви ботів
У старих списках правил часто трапляються anthropic-ai або Claude-Web — токени, якими Anthropic користувалася до ClaudeBot. В актуальній документації Anthropic натомість описано три боти: ClaudeBot, Claude-User і Claude-SearchBot. Файл, у якому названо лише старі токени, на нинішніх ботів не діє. Ви можете думати, що відмовилися від навчання, хоча насправді ні.
Яких ШІ-краулерів можна заблокувати і чого це коштуватиме?
OpenAI та Anthropic мають окремих ботів для навчання, для пошукового індексу і для завантаження сторінки на запит користувача. Perplexity має пошукового краулера і бота для запитів користувачів. Google та Apple замість окремих навчальних краулерів використовують токени відмови.
Навчальні краулери й токени: GPTBot, ClaudeBot, Google-Extended, Applebot-Extended
Вони визначають, чи можна використовувати ваш контент для навчання майбутніх моделей. Від них не залежить, чи з'явитеся ви у відповідях пошуку ChatGPT, Claude або Perplexity. На Google-Extended варто подивитися уважніше, бо він стосується ще й заземлення в застосунках Gemini.
- GPTBot (OpenAI): забороняючи його, ви повідомляєте, що ваш контент не слід використовувати для навчання базових моделей OpenAI.
- ClaudeBot (Anthropic): обмежуючи його, ви сигналізуєте, що майбутні матеріали вашого сайту треба виключити з навчальних наборів даних.
- Google-Extended — токен у robots.txt, а не окремий краулер. Він визначає, чи можна використовувати контент, який сканує Google, для навчання Gemini та заземлення в застосунках Gemini. Заземлення (grounding) — це коли модель отримує свіжий вебконтент у момент відповіді. На присутність і позиції в Google Пошуку Google-Extended не впливає.
- Applebot-Extended теж нічого не сканує. Він повідомляє Apple, чи можна використовувати дані, зібрані Applebot, для навчання базових моделей Apple. Siri і Spotlight і далі користуються Applebot.
Пошукові краулери: OAI-SearchBot, Claude-SearchBot, PerplexityBot
Ці боти збирають індекс, у якому ШІ-асистенти шукають інформацію для відповідей. Їхнє блокування коштує найдорожче. OpenAI пише, що сайти, які відмовилися від OAI-SearchBot, «не показуватимуться у відповідях пошуку ChatGPT», хоча можуть з'являтися як навігаційні посилання. Anthropic попереджає, що вимкнення Claude-SearchBot може знизити видимість і точність у пошукових результатах для користувачів. Perplexity описує PerplexityBot як бота, що показує сайти й посилається на них у пошукових результатах, і зазначає, що для навчання базових моделей він не використовується.
Боти на запит користувача: ChatGPT-User, Claude-User, Perplexity-User
Ці боти відкривають сторінку, коли про це просить людина. Умовний приклад: покупець вставляє в ChatGPT посилання на сторінку з цінами вашої служби доставки й просить коротко переказати умови. OpenAI пише, що ChatGPT-User не використовується для автоматичного сканування. Оскільки такі запити ініціює користувач, «правила robots.txt можуть не застосовуватися». Perplexity повідомляє, що Perplexity-User здебільшого ігнорує robots.txt з тієї ж причини. Anthropic каже, що її боти дотримуються robots.txt, а вимкнення Claude-User «може знизити видимість вашого сайту для вебпошуку, який спрямовує користувач».
Отже, robots.txt може взагалі не зупиняти ботів OpenAI і Perplexity. Якщо вони все одно не можуть прочитати ваші сторінки, насамперед перевірте правила файрвола та CDN.
Список ШІ-краулерів: власник, завдання, ціна блокування і рекомендоване правило
Правила в останній колонці розраховані на найпоширеніший вибір: не брати участі в навчанні, але з'являтися у відповідях ШІ. Якщо ви не проти, щоб ваш контент використовували для навчання, дозвольте всіх.
| Бот / токен | Власник | Завдання | Чого коштує блокування | Рекомендоване правило |
|---|---|---|---|---|
| GPTBot | OpenAI | Збирає контент для навчання моделей | Нічого для пошуку ChatGPT: це відмова від навчання | Disallow (якщо відмовляєтеся від навчання) |
| OAI-SearchBot | OpenAI | Індексує сайти для пошуку ChatGPT | Вас немає у відповідях пошуку ChatGPT | Allow |
| ChatGPT-User | OpenAI | Відкриває сторінку на запит користувача | ChatGPT не може відкрити вашу сторінку для користувача | Allow; не блокуйте у файрволі |
| OAI-AdsBot | OpenAI | Перевіряє цільові сторінки реклами в ChatGPT на відповідність правилам; за словами OpenAI, його дані не використовуються для навчання | OpenAI не може перевірити ваші рекламні сторінки | Allow, якщо рекламуєтеся в ChatGPT |
| ClaudeBot | Anthropic | Збирає контент для навчання моделей | Ваш майбутній контент виключається з навчальних наборів | Disallow (якщо відмовляєтеся від навчання) |
| Claude-SearchBot | Anthropic | Індексує сайти для пошуку Claude | Нижча видимість і точність у пошукових результатах Claude | Allow |
| Claude-User | Anthropic | Відкриває сторінку на запит користувача | Нижча видимість у пошуку, який спрямовує користувач | Allow |
| PerplexityBot | Perplexity | Показує сайти й посилається на них у пошуку Perplexity | Пошуковий краулер не показує ваш сайт і не посилається на нього | Allow |
| Perplexity-User | Perplexity | Відкриває сторінку на запит користувача | Perplexity не може прочитати вашу сторінку для користувача | Allow; не блокуйте у файрволі |
| Google-Extended | Токен: навчання Gemini і заземлення в застосунках Gemini | Контент не використовується для навчання й заземлення Gemini; на Google Пошук не впливає | На ваш вибір: Disallow, щоб відмовитися від навчання, Allow, якщо заземлення в Gemini важливіше | |
| Applebot-Extended | Apple | Токен: навчання моделей Apple | На Siri і Spotlight не впливає | Disallow (якщо відмовляєтеся від навчання) |
Googlebot і Bingbot у таблиці немає, бо жоден ШІ-токен їх не замінює. AI Overviews і AI Mode від Google працюють на Googlebot і звичайних налаштуваннях Пошуку, а не на Google-Extended. Окремого токена для навчання ШІ в Microsoft немає. Для Bing Chat (тепер Copilot) Microsoft пропонує метатеги NOCACHE і NOARCHIVE, щоб обмежити використання вашого контенту у відповідях чату. Заблокувавши Googlebot чи Bingbot, ви втратите значно більше, ніж відповіді ШІ.
Шаблон robots.txt для ШІ-ботів: без навчання, але з присутністю у відповідях
Скопіюйте шаблон і замініть закриті розділи та адресу sitemap на свої. Кілька рядків User-agent можуть мати одну спільну групу правил.
# Пошукові ШІ-краулери: дозволяємо
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Allow: /
Disallow: /checkout/
Disallow: /account/

# Боти на запит користувача: дозволяємо
User-agent: ChatGPT-User
User-agent: Claude-User
User-agent: Perplexity-User
Allow: /
Disallow: /checkout/
Disallow: /account/

# Навчальні краулери й токени: відмовляємося
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
Disallow: /

# Усі інші, зокрема Googlebot і Bingbot
User-agent: *
Disallow: /checkout/
Disallow: /account/

Sitemap: https://www.example.com/sitemap.xml
Не пропустіть чотири деталі:
- Повторюйте закриті розділи в кожній іменованій групі. Краулер виконує лише найконкретнішу групу, яка йому відповідає. Щойно ви виділили OAI-SearchBot в окрему групу, він ігнорує все під
User-agent: *, зокрема ваше правило для/checkout/. - Рішення щодо Google-Extended ухваліть окремо. У шаблоні він стоїть у групі відмови, але стосується ще й заземлення в застосунках Gemini. Якщо видимість у Gemini для вас важливіша за відмову від навчання, видаліть цей рядок.
- У рядку Sitemap вказуйте повну адресу. Цей рядок може стояти будь-де у файлі, але адреса має бути абсолютною й вести на sitemap, який справді відкривається.
- Сповільнюйте ботів замість того, щоб блокувати. Якщо вас турбує навантаження на сервер, Anthropic підтримує нестандартне правило
Crawl-delay, наприкладCrawl-delay: 1. Розмістіть його в групі, де названо лише ботів Anthropic. Це кращий варіант, ніж блокувати пошукового краулера.
Якщо ви не проти навчання на вашому контенті, видаліть групу навчальних ботів: тоді вони виконуватимуть групу *. OpenAI зазначає, що коли ви дозволяєте і GPTBot, і OAI-SearchBot, вона може використати одне сканування для обох цілей.
Як перевірити, що правила robots.txt справді працюють?
Правильний файл на вашому ноутбуці мало що доводить. Важить те, що отримує кожен бот, коли звертається до сайту. Пройдіть ці кроки по черзі.
- Перевірте налаштування ботів у CDN і WAF. Шукайте перемикачі блокування ШІ-ботів, керований robots.txt, режими боротьби з ботами й ліміти запитів. Якщо CDN керує robots.txt, він може замінити завантажений вами файл або дописати до нього правила.
- Відкрийте живий robots.txt на кожному хості. Перевірте вашсайт.com, www.вашсайт.com і кожен піддомен із контентом: кожному хосту потрібен власний файл. Відповідь має бути 200 зі звичайним текстом, а не HTML-сторінкою, формою входу чи CAPTCHA. Згідно з протоколом виключення роботів (RFC 9309), якщо robots.txt повертає помилку сервера (5xx) або недоступний, краулери мають вважати, що заборонено все.
- Перевірте кожну групу user-agent. Прочитайте файл очима кожного бота: знайдіть групу, де його названо, а якщо такої немає — групу
*. Переконайтеся, що результат збігається з таблицею вище. Стежте за одруківками: бот із помилкою в назві створює групу, яку ніхто не виконує. - Почитайте логи сервера. Відфільтруйте записи за user agent: GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, Claude-SearchBot, Claude-User, PerplexityBot і Perplexity-User. Шукайте відповіді 403, 429 і 5xx. Google-Extended і Applebot-Extended у логах не з'являться ніколи: це токени, а не краулери. OpenAI пише, що OAI-SearchBot і GPTBot можуть додавати до user agent позначку «robots.txt», коли завантажують цей файл, тож такі запити легко відрізнити від запитів сторінок.
- Перевіряйте ботів за IP, перш ніж додавати їх до білого списку. Підробити user agent може будь-хто. OpenAI публікує діапазони IP на openai.com/searchbot.json, openai.com/gptbot.json і openai.com/chatgpt-user.json і радить дозволити діапазони OAI-SearchBot. Perplexity теж публікує діапазони своїх ботів. Для Anthropic дотримуйтеся вказівок щодо перевірки на її довідковій сторінці.
- Перевірте посилання на sitemap. Відкрийте адресу Sitemap із robots.txt. Переконайтеся, що файл завантажується, не закритий для ботів і містить важливі сторінки: послуги, ціни, контакти.
- Зачекайте й перевірте ще раз. За словами OpenAI, її пошуковим системам потрібно близько 24 годин, щоб урахувати оновлений robots.txt. Після цього знову перегляньте логи.
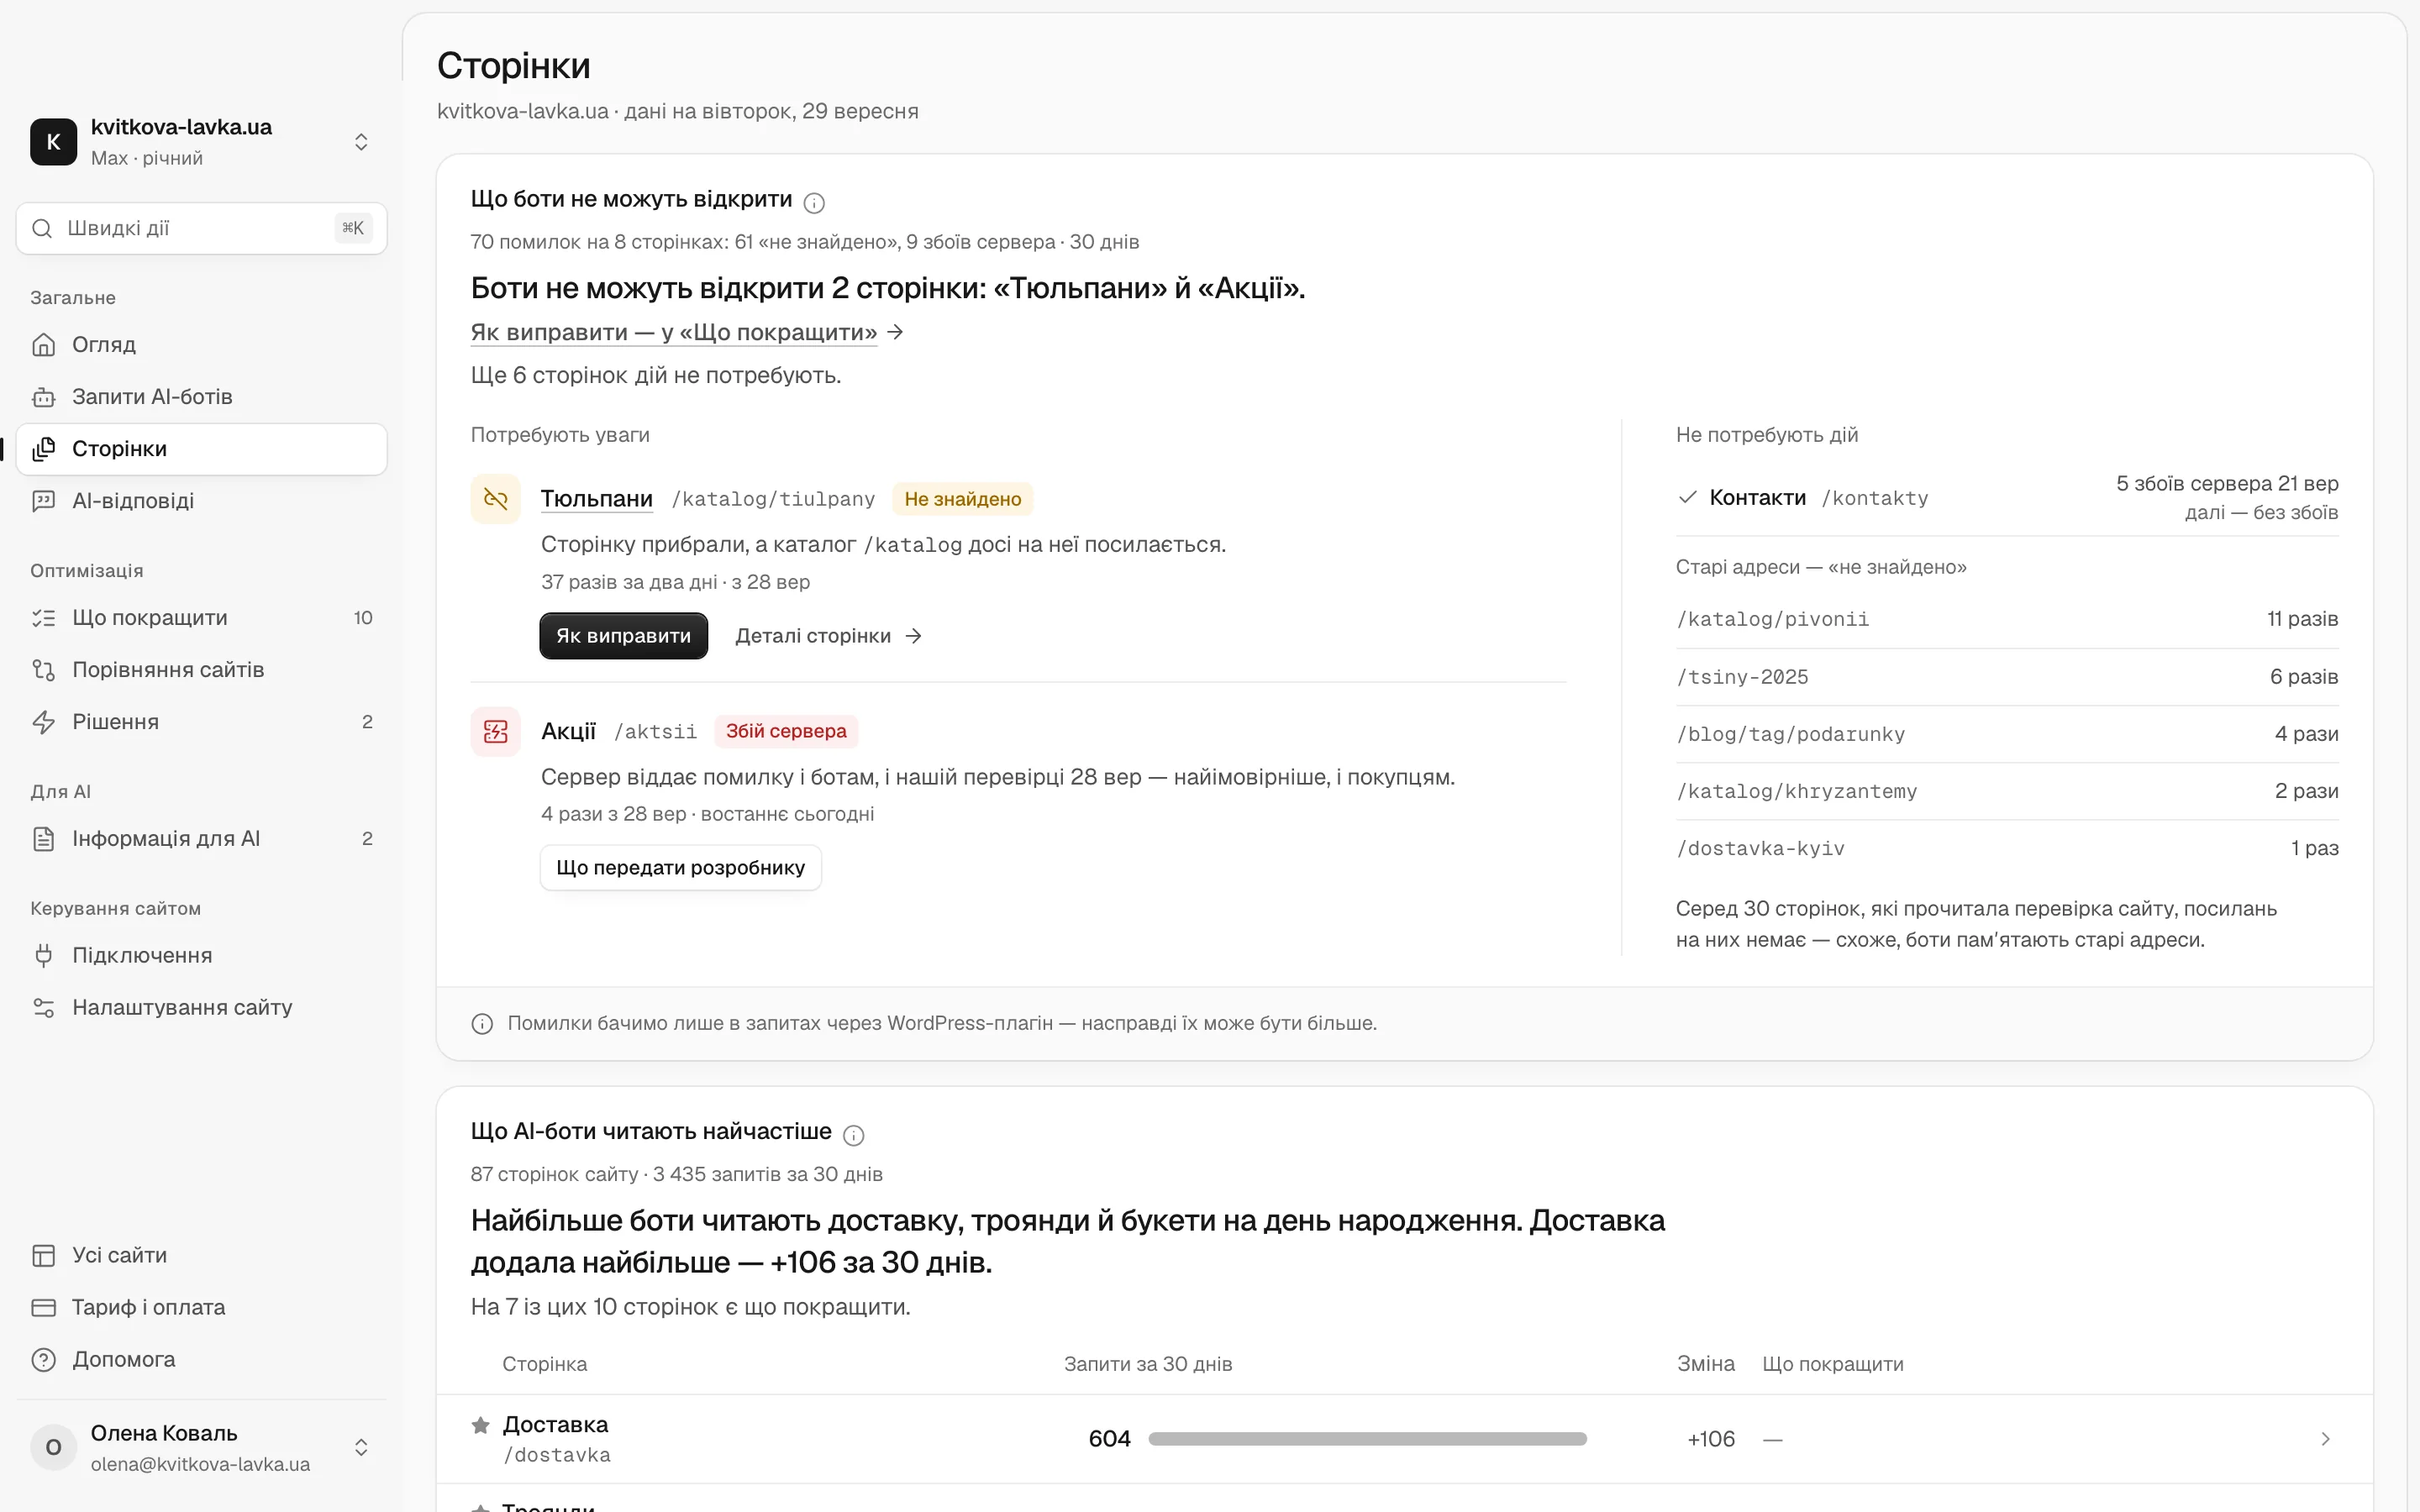
Щотижня читати сирі логи — це час. Pulse робить це за вас: показує, які ШІ-боти від ChatGPT, Claude, Gemini та інших справді заходять на ваш сайт, що вони читають і де натрапляють на помилки. До кожної проблеми додано пораду, що змінити.
Чого robots.txt не вміє?
Robots.txt — це прохання, а не замок. У RFC 9309 сказано, що його правила «не є формою авторизації доступу». Сумлінні краулери їх дотримуються, але ніщо їх до цього не змушує. У серпні 2025 року Cloudflare повідомила, що Perplexity використовувала незадекларованих краулерів, щоб обходити заборони на сканування. Perplexity це заперечила. Якщо контент має залишатися приватним, сховайте його за авторизацією.
Robots.txt — лише один із сигналів, які можна надсилати ШІ-системам. У нашому дослідженні про llms.txt та інші сигнали для ШІ-краулерів у 2026 році ми розбираємо llms.txt, метатеги та інші варіанти й пояснюємо, що робить кожен із них.
Що зробити вже цього тижня?
Почніть із найшвидшої перевірки. Відкрийте вашсайт.com/robots.txt у браузері, знайдіть групи для OAI-SearchBot, Claude-SearchBot і PerplexityBot, а потім перевірте налаштування ботів у CDN. За кілька хвилин ви знатимете, чи взагалі можуть дістатися до вас боти, з яких складаються відповіді ШІ.
Щоб побачити всю картину одразу, пройдіть безкоштовну ШІ-перевірку. Вона покаже, яким бачить ваш бізнес ШІ і що зробити, щоб він називав вас, а не когось іншого.
Часті питання
Якщо заблокувати GPTBot, ChatGPT перестане цитувати мій сайт?
Ні. GPTBot збирає контент, який може використовуватися для навчання моделей OpenAI, а OpenAI зазначає, що налаштування кожного краулера незалежні. Пошук ChatGPT працює на OAI-SearchBot, тож GPTBot можна заборонити, а OAI-SearchBot залишити дозволеним. Дозвіл робить цитування можливим, але не гарантує його.
Чи дотримується ChatGPT-User правил robots.txt?
Не завжди. OpenAI пише, що правила robots.txt можуть не застосовуватися до ChatGPT-User, бо запит ініціює користувач. Perplexity повідомляє, що Perplexity-User з тієї ж причини здебільшого ігнорує robots.txt. Anthropic каже, що її боти, зокрема Claude-User, дотримуються robots.txt. Якщо ці боти не можуть відкрити ваші сторінки, перевірте правила файрвола та CDN на відповіді 403 і перевірки.
Чи зникну я з AI Overviews у Google, якщо заблокую Google-Extended?
Ні. Google-Extended визначає, чи використовується ваш контент для навчання Gemini та заземлення в застосунках Gemini. На присутність і позиції в Google Пошуку він не впливає. AI Overviews і AI Mode працюють на Googlebot і звичайних налаштуваннях Пошуку.
Якщо я зараз заблокую GPTBot чи ClaudeBot, мій старий контент видалять із навчальних даних?
На це не варто розраховувати. У документації Anthropic сказано, що обмеження ClaudeBot виключає з навчальних наборів майбутні матеріали вашого сайту. Сприймайте блокування як сигнал на майбутнє, а не як запит на видалення вже зібраних даних.
Скільки часу минає, поки зміни в robots.txt почнуть діяти в пошуку ChatGPT?
За словами OpenAI, її пошуковим системам потрібно близько 24 годин, щоб урахувати оновлений robots.txt. Після цього перевірте логи сервера й переконайтеся, що OAI-SearchBot отримує відповіді 200.
Чи блокує Cloudflare ШІ-ботів за замовчуванням?
1 липня 2025 року Cloudflare оголосила, що за замовчуванням блокує відомих ШІ-краулерів для нових доменів, а власники можуть їх дозволити. Якщо ШІ-боти не доходять до вашого сайту, перевірте в Cloudflare налаштування ботів і ШІ-краулерів, а також керований robots.txt.