Чи потрібен вашому сайту llms.txt? Для більшості бізнес-сайтів це не терміново. llms.txt — необов'язковий Markdown-файл у корені сайту, де ви перелічуєте ключові сторінки для мовних моделей. Це запропонована домовленість, а не стандарт на кшталт robots.txt, і сам файл не гарантує, що ChatGPT, Gemini чи будь-який інший асистент вас згадає.
Водночас додати його дешево, і шкоди від нього немає. Нижче пояснюємо, що це за файл і що публічно відомо про те, хто його читає. Далі — коли на нього варто витрачати час, як його написати і як перевірити, чи його взагалі запитує хоч один бот.
Що таке llms.txt і чим він відрізняється від robots.txt і sitemap.xml?
llms.txt — це, за словами автора, «пропозиція стандартизувати використання файлу /llms.txt, який надає інформацію, щоб допомогти агентам користуватися сайтом». Уперше її опублікував Джеремі Говард з Answer.AI 3 вересня 2024 року. Чинна версія — v2, востаннє сторінку пропозиції змінили 10 серпня 2026 року.
Файл пишуть у Markdown — простому текстовому форматі, де # позначає заголовок, а [назва](url) — посилання. За специфікацією обов'язковий лише один елемент: заголовок H1 із назвою сайту чи проєкту. Після нього можна додати цитату (blockquote) з коротким описом, довільний текст, а далі розділи H2 зі списками посилань. Після кожного посилання можна поставити двокрапку й коротку примітку.
Сама пропозиція чітко відділяє llms.txt від robots.txt. robots.txt повідомляє автоматичним інструментам, який доступ допустимий. llms.txt має читатися на вимогу — тоді, коли агентові потрібна інформація, щоб допомогти користувачеві. Автор очікував, що файл знадобиться передусім для інференсу (відповідей на запитання), а не для навчання моделей.
У пропозиції пояснено й те, чому з цим не впорається карта сайту. У sitemap часто немає версій сторінок, які мовній моделі легко прочитати, немає корисних зовнішніх посилань, і зазвичай там значно більше сторінок, ніж уміщається в контекстне вікно моделі (обсяг тексту, з яким модель може працювати за раз).
| robots.txt | sitemap.xml | llms.txt | |
|---|---|---|---|
| Призначення | Визначає, яким краулерам до яких шляхів можна доступатися | Перелічує URL, які мають знайти пошукові системи | Дає коротку, вибрану вручну карту ключових сторінок для ШІ-агентів |
| Хто читає | Пошукові та ШІ-краулери, що дотримуються протоколу | Пошукові системи | Жоден великий ШІ-асистент не документує, що читає його. Використовують агенти для програмування та деякі інструменти |
| Керує доступом? | Так, для краулерів, які його поважають | Ні | Ні |
| Формат | Текстові директиви | XML | Markdown |
| Статус | Стандарт IETF (RFC 9309) | Усталений протокол sitemaps | Пропозиція спільноти (v2, серпень 2026) |
Що змінилося в llms.txt v2
Багато статей досі описують першу версію. Якщо ви додаєте файл зараз, зміни у v2 мають значення:
- Файли в підкаталогах. Файл може лежати за адресою
/llms.txtабо в будь-якому підкаталозі, наприклад/docs/llms.txt. Він охоплює URL у межах свого шляху, а агенти мають брати найконкретніший файл. - Markdown-версії сторінок. Пропозиція радить мати чисті Markdown-копії сторінок — або з доданим
.md(page.html.md), або із заміненим розширенням (page.md). Допустимі обидва варіанти. - Виявлення через зв'язки посилань. Сторінка може вказувати на свою Markdown-версію через
rel="alternate" type="text/markdown", а на llms.txt, що її охоплює, — черезrel="describedby". Для цього підходить HTML-елемент<link>або HTTP-заголовокLink:. - Розділ «Optional» тепер просто домовленість. Ним і далі можна позначати другорядні посилання, але особливого технічного значення він більше не має.
Які ШІ-системи насправді читають llms.txt?
Якщо коротко й за першоджерелами: жоден великий ШІ-асистент не документує, що використовує llms.txt чужих сайтів для своїх відповідей. Ось що кожна сторона сказала публічно.
Google: пошукова команда каже, що не використовує його
17 червня 2025 року Джон Мюллер із Google написав: «До речі, жодна ШІ-система зараз не використовує llms.txt». Він додав, що споживчі чат-боти завантажують сторінки для навчання й обґрунтування відповідей, але не файл llms.txt, і це добре видно з логів сервера.
У 2026 році він каже те саме. На Reddit Мюллер назвав це питання «суто гіпотетичним», бо жоден ШІ-сервіс не вимагає й не використовує цей файл. Він також наголосив, що llms.txt не може допомогти моделі вибрати між сайтами, адже його пише сам сайт, який хоче, щоб вибрали саме його. На запитання, чи є файли llms.txt на власних сайтах Google для розробників схваленням формату, він відповів «ні».
Настанови Google 2026 року щодо оптимізації під ШІ-функції Пошуку йдуть ще далі. За переказами Optimizely та Contentful, там сказано, що для появи в AI Overviews чи AI Mode не потрібні ні llms.txt, ні інші спеціальні текстові чи Markdown-файли для ШІ. Наявність такого файлу не допомагає і не шкодить позиціям.
OpenAI, Anthropic і Perplexity: документація про robots.txt, а не про llms.txt
Документація OpenAI про краулерів описує OAI-SearchBot, який показує сайти в пошуку ChatGPT, і GPTBot, який збирає дані для навчання. Кожним із них ви керуєте окремо в robots.txt. Жодної ролі для llms.txt у документації немає. Документації Anthropic чи Perplexity, де було б сказано, що їхні асистенти читають llms.txt чужих сайтів, ми теж не знайшли.
Плутанина виникає тому, що ці компанії самі публікують llms.txt. На llmstxt.org згадано developers.openai.com/llms.txt, docs.anthropic.com/llms.txt і ai.google.dev/gemini-api/docs/llms.txt. Ці файли допомагають розробникам та інструментам для програмування орієнтуватися у власній документації компаній. Опублікувати свій файл — не те саме, що читати ваш.
Що показують дослідження та логи серверів
- SE Ranking проаналізував близько 300 000 доменів і знайшов llms.txt на 10,13% із них. Ні статистична кореляція, ні модель машинного навчання не показали жодного впливу на те, як часто ШІ цитує ці сайти. Ба більше, коли з моделі прибрали змінну llms.txt, її точність зросла.
- Дослідження логів, які зібрала Optimizely, виявили дуже мало запитів до файлу. Limy зафіксувала 408 запитів до llms.txt на понад 500 мільйонів візитів ШІ-ботів за 90 днів. Otterly — 84 запити на понад 62 100 візитів ШІ-ботів за 90 днів, тобто близько 0,1%.
- Оцінки поширеності залежать від вибірки. SE Ranking Visible наводить 13,3% серед 37 894 доменів, які цитує ШІ (Trakkr, березень 2026), і валідний файл на 5,61% із 10 000 найпопулярніших сайтів (HTTP Archive, червень 2026).
Де llms.txt справді використовують
За даними пропозиції, найактивніше файли використовують у документації до програмного забезпечення: агенти для програмування переходять за ними до довідників API та інструкцій. Там само зазначено, що Lighthouse у Chrome перевіряє наявність llms.txt у межах аудитів агентного браузингу. Це перевірка інструмента, а не доказ того, що файл використовують у відповідях ШІ.
Чи потрібен llms.txt саме вам? Коли його варто додати і що виправити спершу
Ставтеся до llms.txt як до дешевого технічного порядку на сайті, а не як до важеля видимості. Чи варті ці 10 хвилин вашого часу, залежить від сайту.
Коли llms.txt варто додати
- Документація, SaaS і API-продукти. Саме тут файл реально використовують агенти для програмування та інструменти документації. Найбільше виграють продукти для розробників.
- Сайти, що сильно залежать від JavaScript. Якщо ціни чи опис послуг з'являються лише після виконання скриптів, Markdown-карта з посиланнями на чисті версії сторінок може стати корисним запасним варіантом для агентів, які читають сирий текст. Але це не замінює виправлення самих сторінок.
- Сервісний бізнес, факти якого важко витягти. У клінік, юридичних фірм і локальних сервісів ціни, години роботи й адреси часто розкидані по багатьох сторінках. Коли ви збираєте їх в одному файлі, заразом перевіряєте, чи вони правильні.
- Ваша платформа вже створює файл. За даними llmstxt.org, Yoast SEO, AIOSEO, Wix, Mintlify і GitBook вміють генерувати його автоматично. Wix створює файл для кожного сайту. Якщо він у вас уже є, залиште його, але відкрийте й перевірте, чи там правильні сторінки.
Коли llms.txt не на часі: спершу виправте це
- robots.txt блокує ШІ-краулерів. Якщо GPTBot, OAI-SearchBot, ClaudeBot чи PerplexityBot заборонені — іноді через налаштування CDN або правила, скопійовані з іншого сайту, — llms.txt нічого не змінить. Які правила мають значення, показує наша карта директив robots.txt та інших сигналів для ШІ-краулерів.
- Боти отримують помилки чи перевірки. Відповіді 4xx і 5xx, сторінки з CAPTCHA та перевірки фаєрвола зупиняють ботів ще до того, як вони щось прочитають.
- На сторінках немає ключових фактів. Якщо ціни, години роботи, зона обслуговування чи контакти не написані в HTML сторінок, спершу додайте їх туди. Як зауважив Мюллер, сайти й далі знаходять через звичайні сторінки та внутрішні посилання.
Як створити файл llms.txt: покрокова інструкція
- Виберіть 5–20 сторінок, що відповідають на реальні запитання клієнтів: послуги, ціни, години роботи, адреси, контакти, умови, а для софту — документація.
- Напишіть H1 з назвою бізнесу чи продукту. Це єдиний обов'язковий елемент.
- Додайте цитату на одне-два речення: що ви робите, для кого і де.
- За бажанням додайте короткий абзац із ключовими фактами. Пишіть прості твердження, а не рекламний текст.
- Згрупуйте посилання в розділи H2, наприклад «Послуги та ціни», «Контакти й години роботи», «Умови». Після кожного посилання поставте двокрапку й коротку примітку.
- Ведіть посилання на чисті сторінки:
.md-версії, якщо вони є, або легкі HTML-сторінки, що повертають статус 200. - Збережіть файл як простий текст у кодуванні UTF-8 і завантажте його за адресою
/llms.txt. Для документації в окремій папці використайте підкаталог, наприклад/docs/llms.txt. - Відкрийте URL і перевірте відповідь: статус 200, текстовий тип вмісту (
text/plainабоtext/markdown), жодного перенаправлення на головну чи перевірки для ботів. - За бажанням додайте підказки для виявлення з v2:
<link rel="describedby" href="/llms.txt">у head сторінки або заголовокLink: </llms.txt>; rel="describedby". На сторінках із Markdown-копіями додайтеrel="alternate" type="text/markdown". - Протестуйте файл. Дайте його ChatGPT чи Claude і запитайте: «Що це за бізнес? Скільки коштують послуги? Коли він працює?» Схожий тест пропонує і сама пропозиція.
Шаблон llms.txt для сервісного бізнесу
Умовний приклад: київська сантехнічна служба «Чиста труба». Компанія, ціни й адреси нижче вигадані й лише показують структуру:
# Чиста труба


> Ремонт і монтаж сантехніки в Києві та передмісті. Працюємо з понеділка по суботу, з 8:00 до 20:00. Аварійний виклик — цілодобово.


«Чиста труба» обслуговує квартири, приватні будинки й малий бізнес. Ціни нижче — стартові; остаточну вартість називаємо після огляду на місці.


## Послуги та ціни


- [Аварійний ремонт](https://www.example.com/services/emergency.md): виклик від 500 ₴, цілодобово

- [Встановлення бойлера](https://www.example.com/services/water-heaters.md): від 2 500 ₴, демонтаж старого включено

- [Прочищення каналізації](https://www.example.com/services/drains.md): від 800 ₴


## Контакти й години роботи


- [Контакти та запис](https://www.example.com/contact.md): телефон, email, онлайн-запис

- [Зона обслуговування](https://www.example.com/service-area.md): райони Києва та населені пункти області


## Умови


- [Гарантія](https://www.example.com/warranty.md): 12 місяців на деталі та роботу

- [Оплата й скасування](https://www.example.com/payment.md): способи оплати, умови скасування


## Optional


- [Поради з догляду](https://www.example.com/blog.md): сезонні поради власникам житла
Чи потрібен ще й llms-full.txt?
llms-full.txt — окрема домовленість: уся ваша документація, зібрана в один Markdown-файл. До тексту пропозиції v2 він не входить, хоча сайти з документацією його часто використовують. Наприклад, Anthropic має і docs.anthropic.com/llms.txt, і /llms-full.txt.
Для сайтів із документацією ми радимо обидва файли. Для більшості маркетингових і сервісних сайтів достатньо короткої карти.
Як перевірити, чи ШІ-боти справді запитують ваш llms.txt
Додати файл — найпростіше. А от перевірка, чи його хтось читає, підкаже, чи варто витрачати на нього більше часу.
Варіант 1: логи сервера чи CDN. Знайдіть у журналах доступу запити до файлу, а потім відфільтруйте їх за юзер-агентами ШІ:
grep "llms.txt" access.log | grep -Ei "gptbot|oai-searchbot|chatgpt-user|claudebot|claude-user|perplexitybot|perplexity-user"
Далі перевірте IP-адреси: юзер-агент може підробити будь-хто. OpenAI публікує діапазони IP своїх краулерів за адресами openai.com/searchbot.json і openai.com/gptbot.json, як описано в її документації про краулерів. Коли вже відкрили логи, подивіться заразом, які звичайні сторінки запитують ці боти і які коди статусу отримують.
Варіант 2: Pulse. Pulse від Chetver показує, які боти ChatGPT, Claude, Gemini та інших ШІ відвідують ваш сайт, що вони читають і де натрапляють на проблеми. До кожної проблеми — порада, що змінити. На тарифі Pro Pulse показує, які ШІ-боти читають які сторінки і де отримують помилки. Ви побачите, чи є /llms.txt серед URL, які вони запитують, і чи не віддають помилок ваші ключові сторінки.
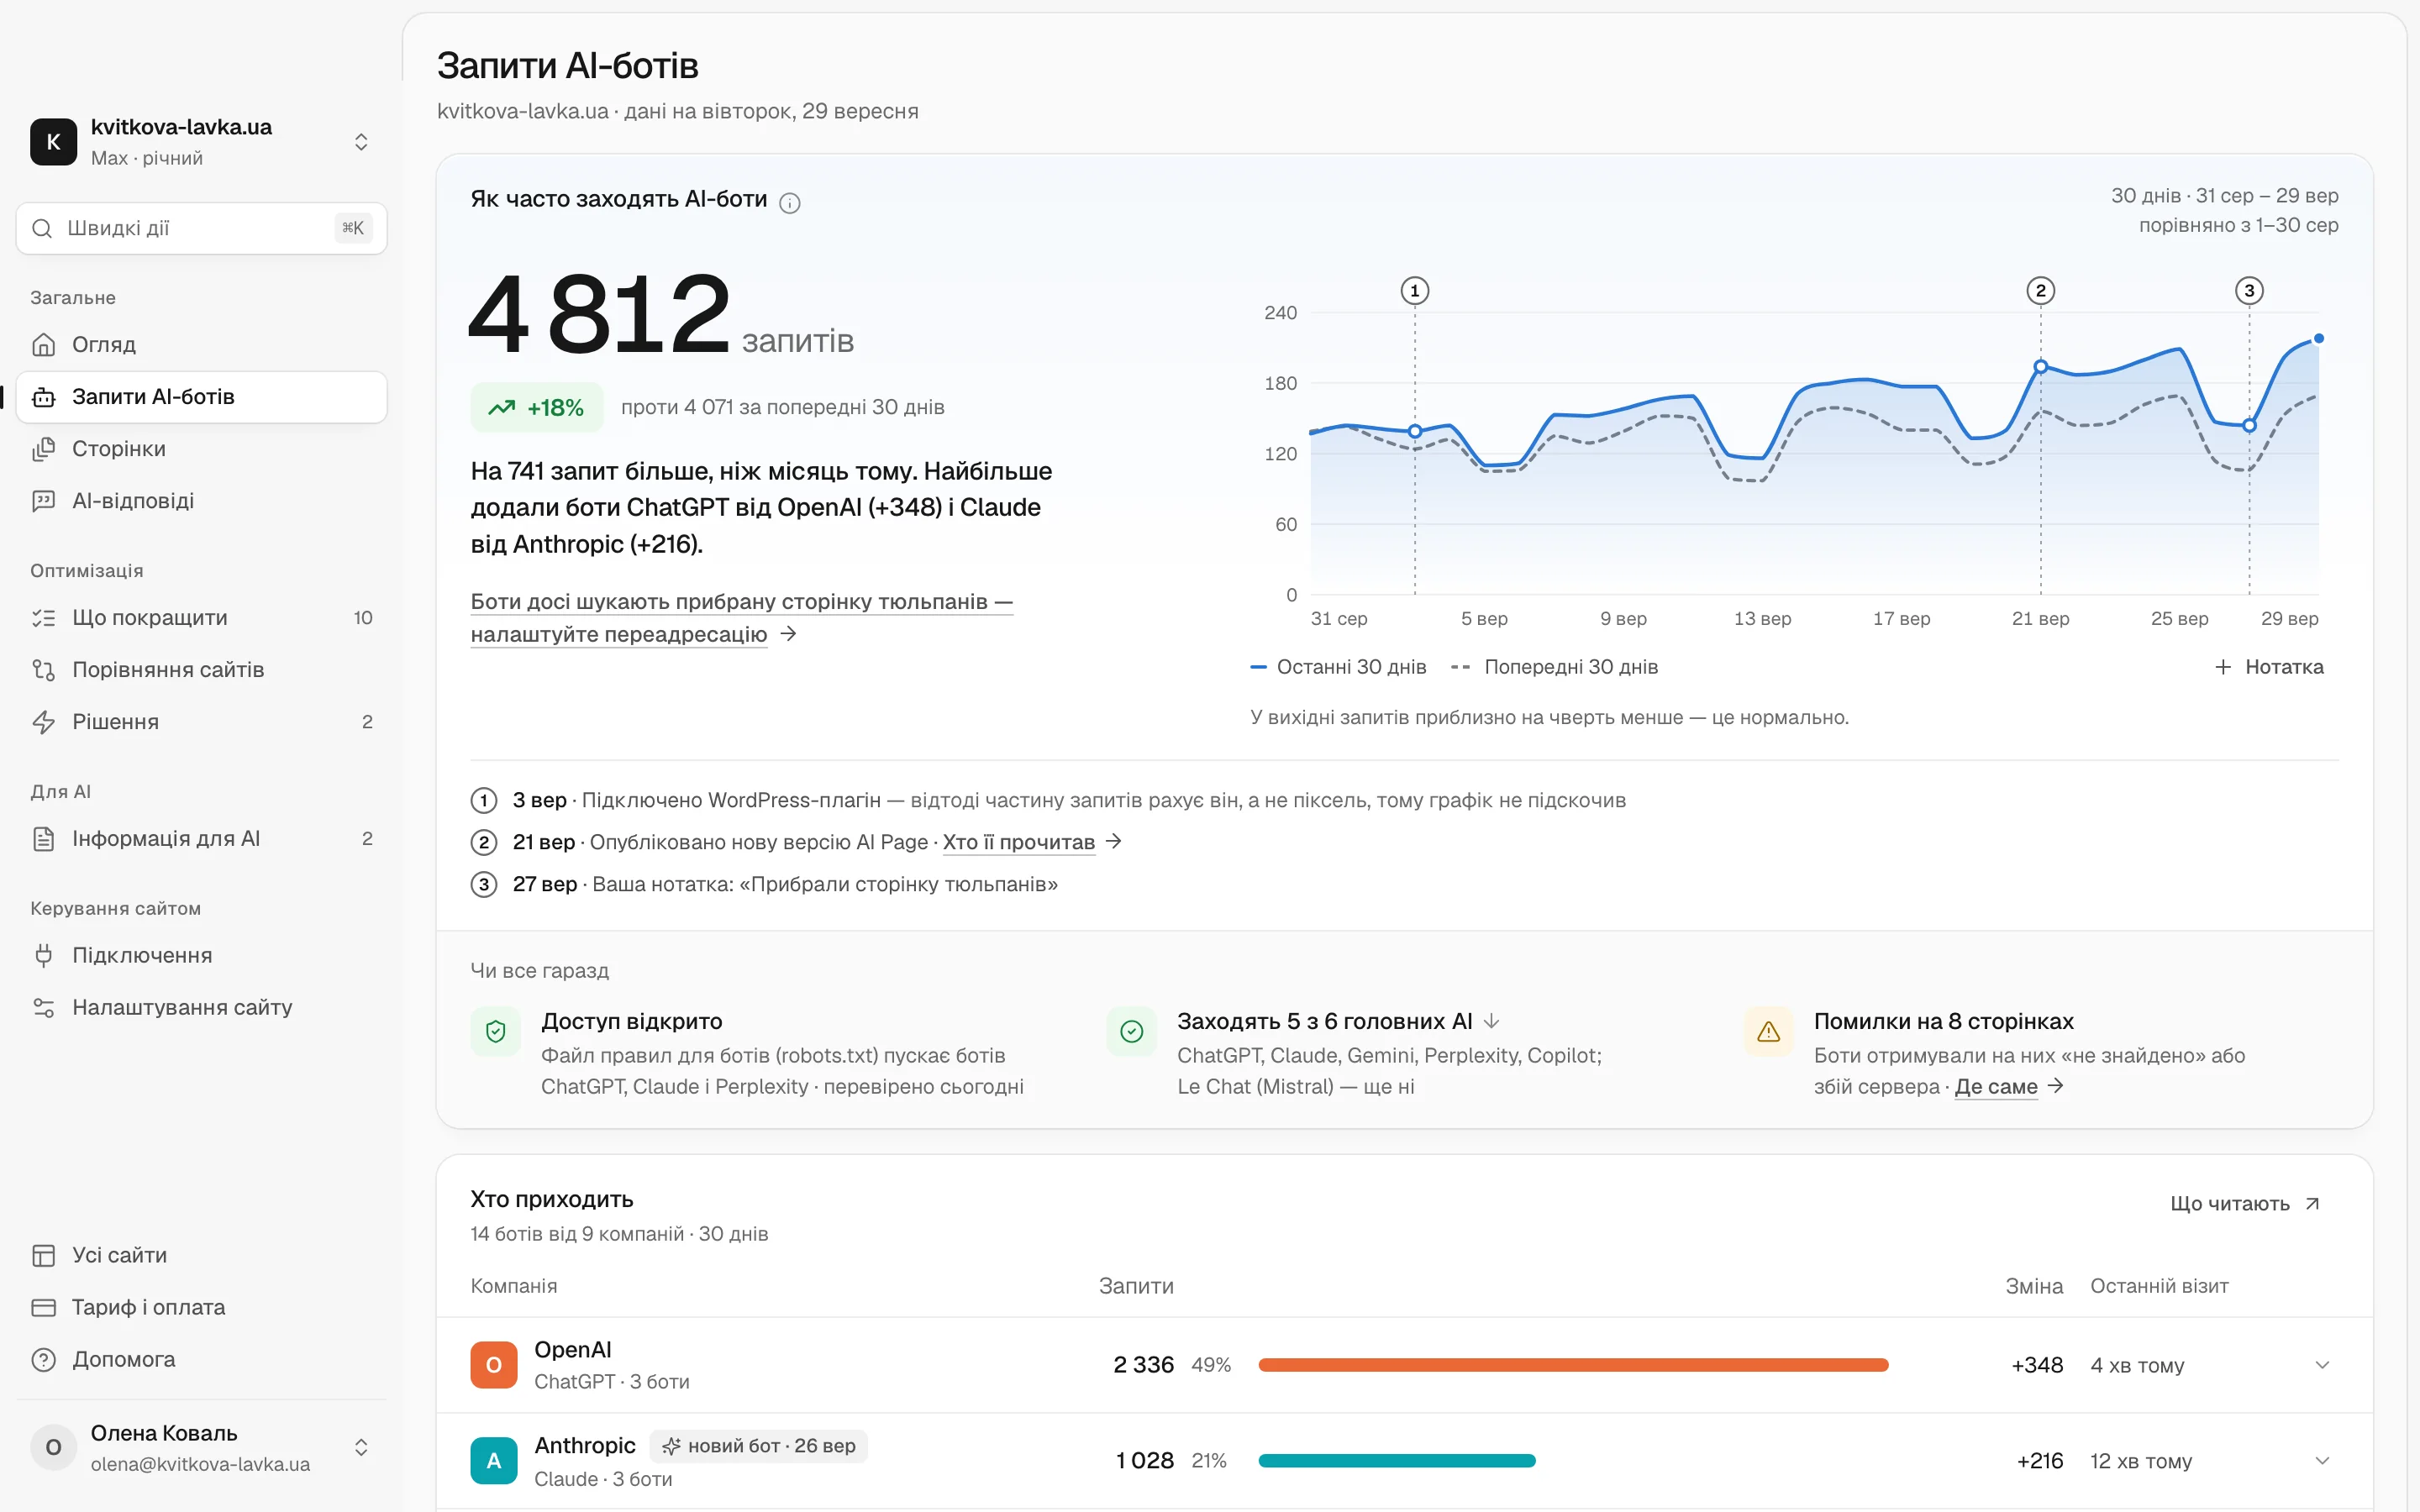
Якщо файл ніхто не запитує, нічого не зламано. Це збігається з результатами досліджень логів вище. Залиште файл, оновлюйте його, а зусилля спрямуйте на сторінки, які боти справді читають: вони мають повертати 200, завантажуватися без перевірок і містити ваші факти простим текстом.
Яке місце тут займає AI Page від Chetver
AI Page — одна сторінка з фактами про ваш бізнес для ChatGPT, Claude та інших ШІ-асистентів: ціни, години роботи, контакти й послуги. Chetver збирає її з вашого сайту, а ви публікуєте її на aipage.yoursite.com. До неї додається файл llms.txt, тож писати його вручну не доведеться.
Для AI Page діє те саме застереження, що й для llms.txt: жоден файл чи сторінка не гарантує згадок у відповідях ШІ. Їхня цінність у тому, що ваші факти зібрані в одному чистому, правильному й зручному для читання місці. Ширшу картину — llms.txt, директиви robots.txt та інші сигнали, які можна надсилати ШІ-краулерам, — дає наша дослідницька карта сигналів для ШІ-краулерів у 2026 році.
Чекліст llms.txt на 10 хвилин
- Відкрийте
yoursite.com/llms.txt— можливо, ваша платформа вже створила файл. - Спершу перевірте robots.txt: GPTBot, OAI-SearchBot, ClaudeBot і PerplexityBot не мають бути заблоковані випадково.
- Переконайтеся, що на ключових сторінках ціни, години роботи, адреси й контакти написані простим текстом.
- Напишіть або виправте H1 і короткий опис у цитаті.
- Перелічіть 5–20 ключових сторінок у розділах H2, кожну з короткою фактичною приміткою.
- Відкрийте кожне посилання й переконайтеся, що воно повертає 200.
- Перевірте, що файл віддається як простий текст зі статусом 200, без перенаправлення чи перевірки для ботів.
- За бажанням додайте
rel="describedby"з посиланням на/llms.txt. - Вставте файл у ChatGPT чи Claude і запитайте, чим займається ваш бізнес і скільки коштують послуги.
- Поставте щомісячне нагадування в календарі: оновлювати файл, коли змінюються ціни, години роботи чи послуги, і перевіряти логи на запити.
Ваш наступний крок: перш ніж редагувати llms.txt, приділіть п'ять хвилин другому пункту цього списку. Краулер, який не може потрапити на ваш сайт, не прочитає жодного файлу. Коли з доступом і фактами все гаразд, llms.txt стане швидким і нешкідливим завершальним штрихом. Щоб побачити, як ШІ-асистенти описують ваш бізнес сьогодні і що зробити, аби вони називали саме вас, пройдіть безкоштовну ШІ-перевірку.
Часті питання
Чи читає ChatGPT файл llms.txt?
Публічної документації, яка б це підтверджувала, немає. Документація OpenAI про краулерів описує OAI-SearchBot і GPTBot та як керувати ними в robots.txt, але жодної ролі для llms.txt там немає. OpenAI публікує llms.txt для власної документації для розробників, проте це не означає, що ChatGPT читає ваш.
Чи використовує Google llms.txt для AI Overviews або AI Mode?
Ні. Джон Мюллер із Google неодноразово казав, що Google не використовує llms.txt. За переказами настанов Google 2026 року щодо ШІ-функцій Пошуку, llms.txt не потрібен для появи в AI Overviews чи AI Mode, а його наявність не допомагає і не шкодить позиціям.
llms.txt — це офіційний стандарт, як robots.txt?
Ні. llms.txt — пропозиція спільноти, яку Джеремі Говард з Answer.AI вперше опублікував у вересні 2024 року; версія 2 вийшла в серпні 2026 року. robots.txt — стандарт IETF (RFC 9309).
Чи можна через llms.txt заблокувати ШІ-краулерів або навчання ШІ на моєму сайті?
Ні. llms.txt лише перелічує сторінки й не керує доступом. Щоб дозволити чи заблокувати краулерів на кшталт GPTBot, OAI-SearchBot, ClaudeBot чи PerplexityBot, використовуйте robots.txt.
Чи може llms.txt зашкодити SEO?
За переказами настанов Google 2026 року, наявність llms.txt не допомагає і не шкодить позиціям. Практичний ризик — застаріла інформація, наприклад старі ціни чи биті посилання, тож оновлюйте файл щоразу, коли змінюються ваші факти.
Чим llms.txt відрізняється від llms-full.txt?
llms.txt — коротка Markdown-карта ключових сторінок. llms-full.txt — окрема домовленість, за якою всю документацію збирають в один файл; до тексту пропозиції llms.txt v2 він не входить. Сайти з документацією часто публікують обидва, а більшості бізнес-сайтів достатньо короткої карти.