Чи блокувати навчання AI на своєму сайті? Я блокував би його лише тоді, коли ви продаєте саме контент. Для більшості малих і середніх бізнесів рішення про навчання важить менше, ніж здається.
Справжній ризик в іншому: заблокувати ботів, які завантажують ваші сторінки, коли ChatGPT, Copilot, Gemini чи Perplexity складають відповідь. Власники сайтів часто закривають їх випадково, разом із ботами для навчання. Моє правило просте: про навчання вирішуйте з огляду на те, як заробляєте, а ботів для відповідей залиште відкритими.
Момент для цього рішення якраз слушний. 30 жовтня 2026 року Microsoft Bing оголосив окремі, незалежні налаштування для навчання AI та для AI grounding, тобто використання сторінок у відповідях. Того ж дня Google і OpenAI заявили, що планують враховувати один спільний сигнал навчання в robots.txt. Уперше більшість власників сайтів може зробити ці два вибори окремо.
Навчання і відповіді — це дві різні речі
Визначення Microsoft — найчіткіші з тих, що я бачив. Навчання AI — це використання вашого контенту, щоб змінити параметри моделі. AI grounding — це використання вашого контенту як вхідних даних для відповіді, яку генерує AI. Індексування і ранжування сторінок у звичайному пошуку не належить ні до того, ні до іншого.
Навчання — непрямий вплив: ваша сторінка стає одним із безлічі джерел, з яких вчиться модель. Grounding відбувається в момент запиту. Клієнт ставить питання, бот завантажує вашу сторінку, і асистент може назвати вас і дати посилання. Якщо ви заблокуєте grounding, асистент не зможе використати вашу сторінку для цієї відповіді. Він збере її з інших джерел, і серед них можуть бути ваші конкуренти.
До цієї осені більшість власників сайтів сприймали навчання і grounding як одне рішення. З 2023 року Microsoft керував обома через NoArchive і NoCache. Токен Google-Extended від Google досі охоплює обидва. Довгі списки «заблокуйте всіх AI-ботів» змішували обидва типи. В OpenAI, Anthropic і Perplexity боти вже були окремі, але мало хто читав документацію так уважно.
| Бот або токен | Що робить | Тип |
|---|---|---|
| GPTBot (OpenAI) | Визначає, чи використовується ваш контент для навчання | Навчання |
| OAI-SearchBot (OpenAI) | Визначає, чи може сайт з'являтися в результатах пошуку ChatGPT | Відповіді |
| ChatGPT-User (OpenAI) | Відкриває сторінку, коли користувач просить про це ChatGPT | Відповіді |
| ClaudeBot (Anthropic) | Збирає дані для навчання | Навчання |
| Claude-SearchBot, Claude-User (Anthropic) | Покращують результати пошуку і завантажують сторінки на запити користувачів | Відповіді |
| PerplexityBot, Perplexity-User | Показують сайти з посиланнями у відповідях Perplexity; завантажують сторінки на дії користувача | Відповіді |
| Google-Extended (токен, не краулер) | Навчання Gemini і, за даними медіа, grounding у застосунках Gemini | Обидва |
| Googlebot, Bingbot | Пошук, а також AI Overviews і AI Mode від Google та grounding у Copilot від Microsoft | Відповіді |
Ролі ботів узято з публікацій про краулери OpenAI, довідки Anthropic, гайда Perplexity про краулери і списку краулерів Google. Важлива деталь: правила robots.txt можуть не діяти на боти, що працюють за запитом користувача, як-от ChatGPT-User і Perplexity-User, адже сторінку попросила людина. А от блокування у фаєрволі їх зупиняє.
Синтаксис robots.txt я тут не повторюватиму. Як ці сигнали поєднуються між собою, показує наша мапа llms.txt та інших сигналів для AI-краулерів у 2026 році.
Що змінилося 30 жовтня 2026 року, а що ні
Спільний сигнал — це група в robots.txt з назвою User-Agent: __usage_ai-training. Вона походить з чернетки IETF (Internet-Draft), яку написав Кевін Келлі з Anthropic. Internet-Draft — це робоча пропозиція, а не готовий стандарт. Google трактуватиме відмову через цей токен як заборону для Google-Extended, якщо ви не вказали Google-Extended окремо.
OpenAI заявляє, що враховуватиме токен протягом найближчих місяців, а доти діють її нинішні правила robots.txt. За повідомленнями, Anthropic уже почала його впроваджувати, але сторінки Anthropic, яка б це підтверджувала, я не бачив.
Не менш важливо, що залишилося як було. Згідно з чернеткою, файли robots.txt, опубліковані сьогодні, не виражають жодного спільного вибору, бо цієї групи в них ще немає. Працюють ваші наявні правила для GPTBot, ClaudeBot і Google-Extended. OpenAI, Google і Anthropic кажуть, що налаштування для окремих ботів залишаються.
| Дата | Що відбувається |
|---|---|
| 15 грудня 2026 | У Bing Webmaster Tools з'являються тимчасові налаштування grounding, лише для сайтів, що використовують NoArchive/NoCache |
| 1 лютого 2027 | Bing починає застосовувати нові налаштування в міру повторного сканування сторінок |
| 1 березня 2027 | Bing перестає враховувати NoArchive/NoCache для навчання і grounding |
| 3 травня 2027 | Спливає термін дії чинної чернетки Internet-Draft |
| 30 вересня 2027 | Спливає термін тимчасових налаштувань grounding у Bing |
| 2027 / «найближчі місяці» | Підтримка спільного токена в Google / OpenAI |
Де розділення досі неповне
Google: навчання і відповіді Gemini йдуть у парі
Search Engine Journal і Dataconomy пишуть, що Google-Extended охоплює і grounding у застосунках Gemini. За їхніми даними, документація Google не описує способу розділити ці два використання. Тож якщо ви відмовитеся від навчання через новий токен, то можете випасти й з відповідей у застосунках Gemini.
Окрема група для Google-Extended має пріоритет над спільним токеном, але це все одно один перемикач для обох випадків. Google Пошук, AI Overviews і AI Mode це не зачіпає: ними керує Googlebot, а не Google-Extended.
Microsoft: grounding налаштовується для кожної сторінки
У Bing навчання можна налаштувати для всього сайту в robots.txt і перевизначити для окремих сторінок. Grounding налаштовується лише на рівні сторінки, через метатег або заголовок X-Robots-Tag. Microsoft прямо пише: «Налаштування grounding для всього сайту через robots.txt не існує». За замовчуванням обидва налаштування мають значення Allow.
Є й проміжний варіант — ai-grounding:disallowextended. Він залишає ваші сторінки доступними для власних сервісів Microsoft, як-от Copilot і Microsoft 365, але виключає grounding-сервіси, які Microsoft продає третім сторонам.
Ці налаштування визначають, як Microsoft використовує ваш контент, а не те, чи може Bingbot його сканувати. Allow не скасовує правила robots.txt, яке блокує Bingbot. До того ж Microsoft має повторно просканувати сторінку, щоб побачити нове налаштування.
Правило із зірочкою — це не відмова від навчання
Згідно з чернеткою, групу User-Agent: * не можна трактувати як вибір щодо навчання. Якщо ви думаєте, що ваші загальні правила вже кажуть «ні навчанню», то в новій системі вони не кажуть нічого.
Чи блокувати навчання AI на сайті: правило для рішення
Поставте собі одне питання: чи є ваш контент тим самим продуктом, який ви продаєте? Якщо ні, навчання на ваших сторінках про послуги вам майже нічого не коштує. Якщо так, захищайте його.
| Бізнес | Навчання AI | AI-відповіді |
|---|---|---|
| Локальні послуги, клініка, юридична фірма, агенція | На ваш розсуд; я схиляюся дозволити | Залишити відкритими |
| Інтернет-магазин (зокрема з вітриною на Prom.ua чи Rozetka), SaaS, B2B-лідогенерація | На ваш розсуд; я схиляюся дозволити | Залишити відкритими |
| Видавець із платним архівом або архівом, який можна ліцензувати | Заборонити або ліцензувати | Відкрити на публічних сторінках; у Bing розглянути DisallowExtended |
| Контент — це продукт: курси, дані, рецепти, стокові медіа | Заборонити | Вирішувати посторінково: відкрити продажні сторінки, закрити сам продукт |
Умовний приклад: стоматологічна клініка у Львові. Її ціни в гривнях, графік роботи й перелік процедур — не продукт, який хтось може перепродати. Блокуючи навчання, вона не захищає нічого цінного. А блокуючи відповіді, вона не дає ChatGPT перевірити ці факти, коли пацієнт шукає клініку поблизу.
«Але ж AI краде мій трафік»: найсильніші заперечення
Видавці з контентом, який можна ліцензувати
Це слушне побоювання. Відмова від навчання — розумний вибір, якщо ваш архів коштує грошей. Але Bing зазначає, що його налаштування «не встановлюють ліцензійних чи платіжних домовленостей». Чернетка також дозволяє приватним угодам, як-от ліцензійним, мати пріоритет над спільним сигналом.
Тобто токен зберігає ваші можливості, але не веде переговори за вас. І щоб їх зберегти, не обов'язково прибирати публічні сторінки з відповідей.
AI-підсумки зменшують кількість кліків
Так, зменшують. Pew Research Center проаналізував дані про перегляди 900 дорослих американців за березень 2025 року. Користувачі, які бачили AI-підсумок Google, клікали на звичайний результат у 8% відвідувань, а без підсумку — у 15%. На посилання всередині підсумку вони клікали приблизно в 1% відвідувань.
Це реальна втрата. Але блокування відповідей не поверне стару сторінку пошуку. Воно лише прибере вас із підсумку, який тепер на ній є.
Блокування не повертає кліки
Єдині дані, які я бачив, свідчать про протилежне, і їх небагато. Вторинне джерело описує один сайт, який тестував SEO-фахівець Сайрус Шепард. Його звичайні органічні кліки впали, поки сайт був поза AI Overviews і AI Mode, і відновилися, коли він туди повернувся.
Це один сайт, тож сам по собі він нічого не доводить. Утім, переконливих даних на користь протилежного я не бачив.
Відкритий доступ не гарантує згадок, тож вимірюйте
Microsoft каже прямо: «Жоден із варіантів не гарантує включення, трафіку чи оплати». Якщо ви забороните grounding, Microsoft попереджає, що видимість бренду в AI-сервісах зменшиться. Якщо дозволите, ваші сторінки лише стануть придатними для відповідей. Чи назве вас асистент, залежить від чітких, унікальних фактів на цих сторінках і від того, що про вас кажуть інші джерела.
Тому я вважаю, що видимість в AI треба вимірювати до і після змін, а не обіцяти. Наше дослідження про Share of Model і вимірювання видимості в AI пояснює підхід.
У нашому кейсі Sereda.ai ChatGPT спочатку казав, що не знає цієї HR-платформи. Sereda.ai опублікувала AI Page 22 жовтня 2025 року. Двоє дослідників незалежно оцінили відповіді на 4 питання за 5 критеріями за 100-бальною шкалою. Оцінка зросла з 24 до 87 у ChatGPT і з 28 до 91 у Gemini. «До» — це вересень — початок жовтня 2025 року, «після» — початок грудня 2025 року. Це один кейс, а не типовий результат.
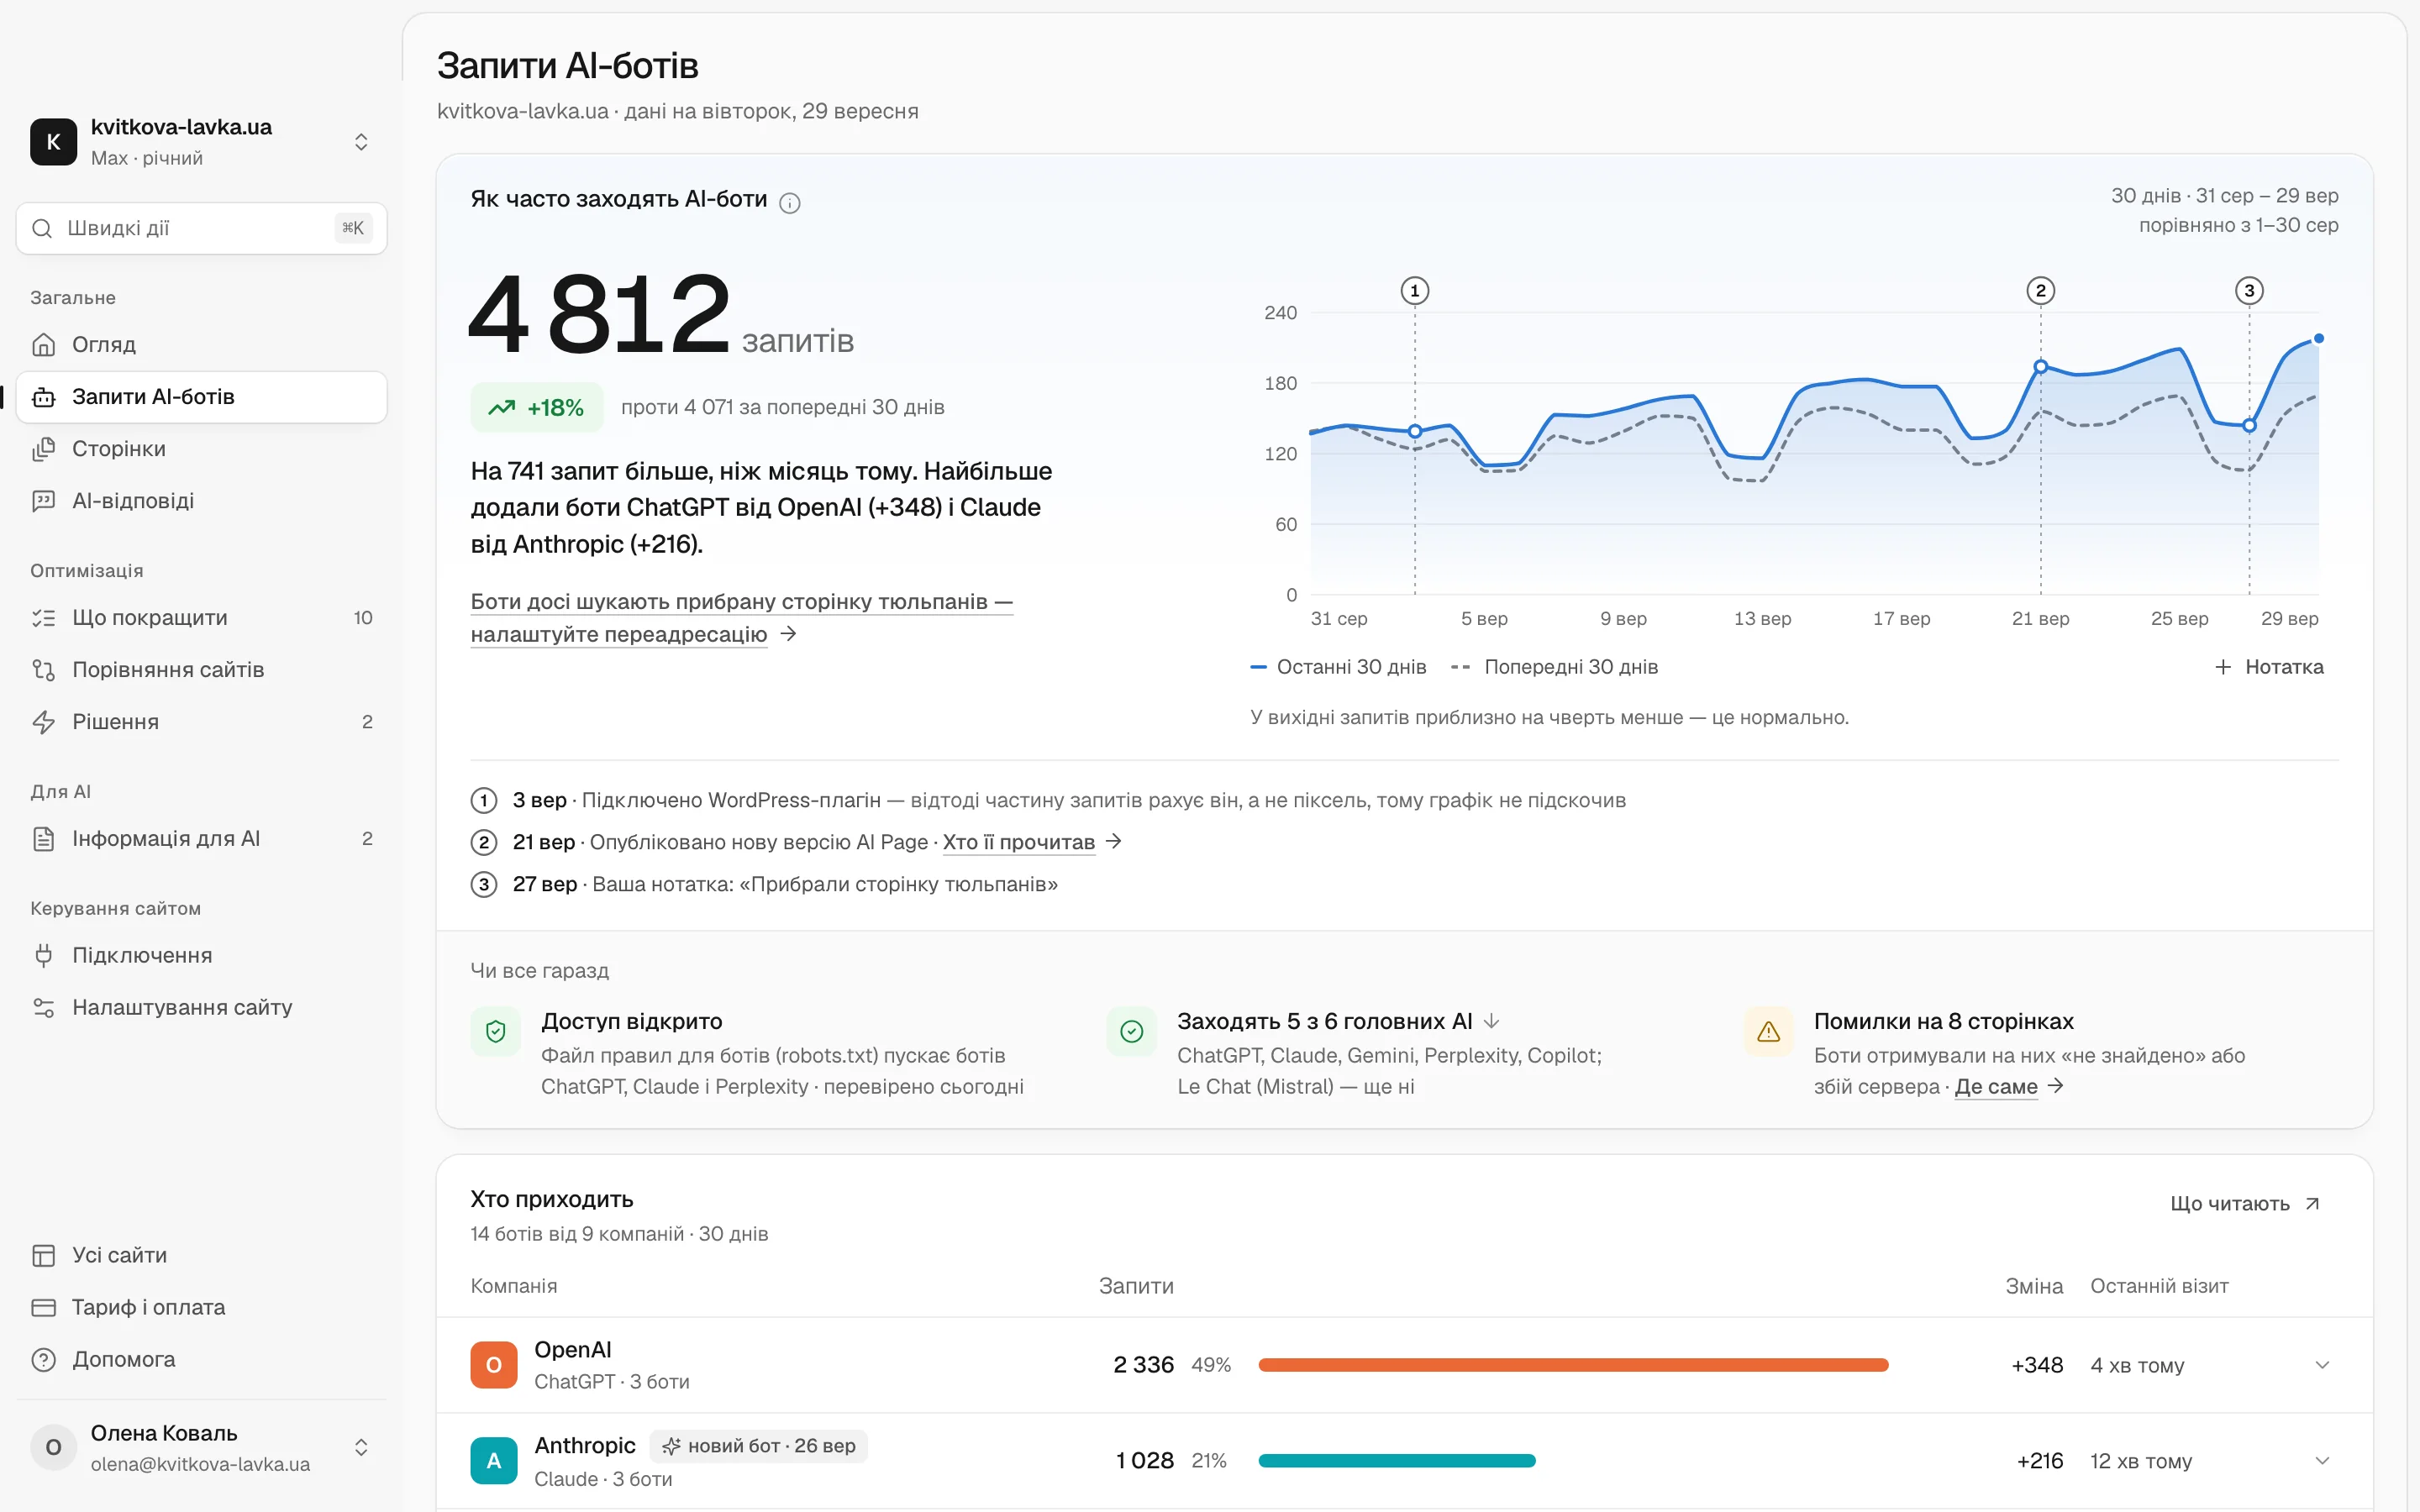
Щодо технічного боку — перевірте серверні логи. Боти для відповідей мають отримувати відповідь 200, а не помилки 403, циклічні редиректи чи перевірки фаєрволу. User-agent можна підробити, тому перевіряйте важливих ботів за IP або зворотним DNS. Якщо не хочете читати сирі логи, Chetver Pulse показує, які AI-боти приходять на сайт, що читають і де натрапляють на помилки.
Що я зробив би на вашому місці
- Подивіться, що ваш сайт віддає насправді. Відкрийте живий robots.txt і перевірте метатеги robots та заголовки X-Robots-Tag на ключових сторінках. Налаштування CDN і фаєрволу можуть змінити файл непомітно для вас. HasData повідомила про зміну в Cloudflare, яка прибрала заборони для AI з файлів robots.txt 118 сайтів.
- Позначте кожне правило як «навчання» або «відповіді». Правило, що блокує OAI-SearchBot, ChatGPT-User, Claude-User, PerplexityBot, Bingbot або Googlebot, має бути там лише тому, що ви свідомо так вирішили.
- Якщо хочете відмовитися від навчання, додайте окрему групу
__usage_ai-training. Правила для GPTBot, ClaudeBot і Google-Extended поки залиште. Свідомо вирішіть, чи готові ви втратити відповіді в застосунках Gemini. - Якщо використовуєте NoArchive чи NoCache для Bing, сплануйте перехід до 1 березня 2027 року. Перенесіть навчання в нову групу robots.txt, а grounding — у теги на рівні сторінок.
- Після кожної зміни знову перевіряйте логи. Боти для відповідей і далі мають отримувати відповідь 200.
Почніть із першого кроку сьогодні. Він займе небагато часу і покаже, які рішення ваш сайт уже ухвалив без вас.
Часті питання
Якщо заблокувати GPTBot, мій сайт зникне з пошуку ChatGPT?
Ні. GPTBot визначає, чи використовується ваш контент для навчання. OAI-SearchBot визначає, чи може ваш сайт з'являтися в результатах пошуку ChatGPT, і ці два налаштування задаються незалежно. ChatGPT-User відкриває сторінки, які користувач просить ChatGPT відкрити.
Що таке __usage_ai-training і чи він уже працює?
Це спільна група в robots.txt, через яку можна висловити вибір щодо навчання AI. Її описує чернетка IETF (Internet-Draft). У великих вендорів вона ще не працює: Microsoft почне її застосовувати з 1 лютого 2027 року, Google планує підтримку у 2027-му, OpenAI обіцяє найближчими місяцями. А доти діють ваші наявні правила для окремих ботів, як-от GPTBot і Google-Extended.
Якщо відмовитися від навчання AI, я зникну з Gemini?
Може статися. Google трактуватиме відмову через спільний токен як заборону для Google-Extended. За даними медіа, Google-Extended охоплює і grounding у застосунках Gemini. Google Пошуком, AI Overviews і AI Mode керує Googlebot, тож на них відмова не впливає.
Чи вважається User-Agent: * Disallow відмовою від навчання AI?
За новою чернеткою — ні. Групу із зірочкою не можна трактувати як вибір щодо навчання. Файл robots.txt без групи __usage_ai-training не виражає жодного спільного вибору. Якщо хочете відмовитися від навчання, потрібна окрема група.
Я використовую NoArchive або NoCache для Bing. Що мені робити?
Сплануйте перехід до 1 березня 2027 року. Після цієї дати Bing перестане враховувати NoArchive і NoCache для навчання та grounding. Навчання налаштовуйте групою __usage_ai-training у robots.txt, а grounding — метатегами на рівні сторінок або заголовком X-Robots-Tag.
Якщо я пущу AI-ботів на сайт, AI-асистенти мене згадуватимуть?
Не обов'язково. Microsoft прямо каже, що жоден варіант не гарантує включення, трафіку чи оплати. Відкритий доступ робить ваші сторінки придатними для відповідей. Чи назве вас асистент, залежить від чітких, унікальних фактів на ваших сторінках і від того, що про вас кажуть інші джерела.