Щоб відстежити трафік AI-ботів, відкрийте логи доступу сервера або логи CDN і відфільтруйте їх за user agent AI-ботів: GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, Claude-User, PerplexityBot. GA4 цього не покаже. Він фіксує людей, які перейшли з відповіді AI, а не сам AI, що прочитав ваш сайт, щоб цю відповідь написати.
Я вважаю, що більшість компаній оцінює свою видимість в AI не за тим звітом. Замість рядка chatgpt.com у реферальних джерелах я дивився б на три числа: які AI-боти запитують які сторінки, які коди відповіді вони отримують і чи з'являються в логах фетчери, яких запускає користувач.
Чому звіт GA4 про «AI-трафік» пропускає більшу частину
GA4 працює через JavaScript-тег, який виконується в браузері відвідувача. AI-краулери зазвичай завантажують HTML і ваші скрипти не запускають. Аналіз мережі Vercel за грудень 2024 року показав: великі AI-краулери завантажують JavaScript-файли, але не виконують їх. Скрипт не запустився — тег не спрацював.
До того ж Google відсіює ботів свідомо. GA4 автоматично виключає трафік відомих ботів і павуків, і вимкнути це чи побачити, скільки відсіяно, не можна. Тож навіть бот, який раптом виконав би тег, до ваших звітів не потрапить.
Лишаються реферальні переходи з chatgpt.com, perplexity.ai та подібних сайтів. За кожним таким візитом — людина, яка вже отримала відповідь і вирішила клікнути. А чимало відповідей закінчуються без кліку.
Умовний приклад: стоматологія у Львові, чию сторінку з цінами ChatGPT читає, перш ніж відповісти користувачеві, скільки коштує профілактичний огляд. Людина одразу телефонує в клініку. Візит, який вирішив справу, у GA4 так і не з'являється, хоча відповідь дала саме сторінка клініки.
Що насправді бачить кожен інструмент
| Інструмент | Що фіксує | Чого не бачить |
|---|---|---|
| GA4 | Сесії людей, зокрема переходи з AI-асистентів | Краулерів і фетчерів. Відомих ботів виключено за задумом |
| Clarity Agent Activity | Сесії, де AI-агент керує справжнім браузером і тег спрацьовує | Краулерів, які лише завантажують HTML; агентів від операторів, яких Clarity не розпізнає |
| Clarity AI Bot Activity | Як AI-краулери та інші боти отримують доступ до вашого контенту (потрібне окреме налаштування) | Охоплення залежить від налаштування; дивіться документацію Microsoft |
| Логи доступу сервера | Кожен запит: IP, URL, код відповіді, user agent | Запити, на які CDN відповів із кешу |
| Логи CDN | Кожен запит на рівні CDN, зокрема відповіді з кешу та блокування файрволом | З боку запитів — нічого, але на деяких тарифах логи зберігаються недовго |
Microsoft Clarity тепер рахує AI-агентів як окрему категорію аналітики
Найпомітніший сигнал, що ринок змінився, з'явився цього місяця. 4 листопада 2026 року Microsoft анонсувала Agentic Analytics у Clarity, а MarketingProfs написав про це в огляді від 6 листопада. Дашборд Agent Activity показує, які агенти заходять на сайт і що там роблять: пошук, надсилання форм, вхід в акаунт, завантаження, запис на прийом, оформлення замовлення. За словами Microsoft, кількість сесій агентів на тиждень майже подвоїлася за три тижні й наблизилася до 2 мільйонів. Це дані самої Clarity, а не всього інтернету.
Є й обмеження. Поки що Clarity розпізнає агентів лише трьох операторів: OpenAI, Google та Anthropic. У дослідженні від 29 жовтня Microsoft повідомила, що агенти доходять до оформлення замовлення частіше, ніж люди. Проте сама Microsoft застерігає, що в цих сесіях могли брати участь люди, яким агент передав керування. А PPC Land, як повідомляє Relevant Audience, знайшов арифметичну розбіжність у відсотках. Я б не будував планів на цих цифрах.
Для краулерів у Clarity є окремий дашборд AI Bot Activity — у розділі Dashboards → AI Visibility. Налаштовують його в Settings → AI Visibility; що для цього потрібно вашому сайту, дивіться в документації Microsoft. Метрика «AI crawl request share» показує частку AI-ботів серед усіх запитів сторінок.
Отже, Microsoft рахує людей, агентів і краулерів окремо. Думаю, у ваших звітах має бути так само.
Які три числа я вимірював би натомість
1. Які AI-боти запитують які сторінки
Почніть з охоплення. Чи доходять боти до сторінок із цінами, послугами, графіком роботи та контактами? Чи витрачають візити на головну й старі статті в блозі? AI потрібні чіткі, конкретні факти про ваш бізнес. Якщо боти не запитують сторінок, де ці факти лежать, — це перша прогалина, яку варто закрити.
2. Які коди відповіді вони отримують
Код відповіді — це тризначне число, яким сервер відповідає на кожен запит. 200 означає «усе гаразд», 301 — «сторінку перенесено», 404 — «не знайдено», 5xx — помилка сервера. У грудневому аналізі 2024 року Vercel повідомив, що краулери ChatGPT і Claude витрачали приблизно третину запитів на сторінки 404.
Шукайте 404, помилки 5xx, блокування 403 від файрволу та ланцюжки редиректів. І ще одну, тихішу проблему: відповідь 200 на сторінці, яка будується лише JavaScript, — бот отримує порожню оболонку замість вашого контенту.
3. Чи з'являються ChatGPT-User і Claude-User
Це фетчери, яких запускає користувач. Вони заходять на вашу сторінку, бо хтось щойно поставив питання ChatGPT чи Claude. З усього, що є в логах, це найближча ознака того, що відповідь складають на основі вашого сайту.
Це сигнал, а не доказ: запит ще не означає, що ваш бізнес назвали у відповіді. Тому я поєдную його з відстеженням того, що AI насправді про вас каже. Про це нижче.
Навчання, пошук чи запит користувача: як розрізняти AI-ботів
| Оператор | User agent | Призначення | robots.txt | Опублікований список IP |
|---|---|---|---|---|
| OpenAI | GPTBot | Навчання | Дотримується | gptbot.json |
| OpenAI | OAI-SearchBot | Пошук у ChatGPT | Дотримується | searchbot.json |
| OpenAI | ChatGPT-User | Дії користувачів | Може не застосовуватися | chatgpt-user.json |
| Anthropic | ClaudeBot | Навчання | Дотримується | Не підтверджено; дивіться довідку Anthropic |
| Anthropic | Claude-SearchBot | Якість пошуку | Дотримується | Не підтверджено; дивіться довідку Anthropic |
| Anthropic | Claude-User | Питання користувачів | Дотримується | Не підтверджено; дивіться довідку Anthropic |
| Perplexity | PerplexityBot | Результати пошуку | Дотримується | Так |
| Perplexity | Perplexity-User | Дії користувачів | Зазвичай ігнорує | Так |
Джерела: OpenAI, Anthropic, Perplexity. У Google інакше. Google-Extended — це лише токен для robots.txt без власного user agent, тож окремим рядком у логах він ніколи не з'явиться.
Як відстежити трафік AI-ботів у логах доступу
- Знайдіть логи. На nginx вони зазвичай лежать у
/var/log/nginx/access.log. На Apache — у/var/log/apache2/або/var/log/httpd/. На віртуальному хостингу шукайте в панелі керування. На CDN — у налаштуваннях експорту логів або аналітики. - Збережіть рядки AI-ботів в окремий файл:
grep -iE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User" access.log > ai-bots.log - Порахуйте сторінки й коди відповіді для одного бота:
grep -i "ChatGPT-User" ai-bots.log | awk '{print $9, $7}' | sort | uniq -c | sort -rn | head -20. У стандартному форматі combined поле 9 — це код відповіді, а поле 7 — URL. - Подивіться розподіл кодів відповіді для всіх AI-ботів:
awk '{print $9}' ai-bots.log | sort | uniq -c - Складіть список IP для перевірки:
awk '{print $1}' ai-bots.log | sort | uniq -c | sort -rn - Щотижня зберігайте знімок, щоб порівнювати стан до і після кожного виправлення.
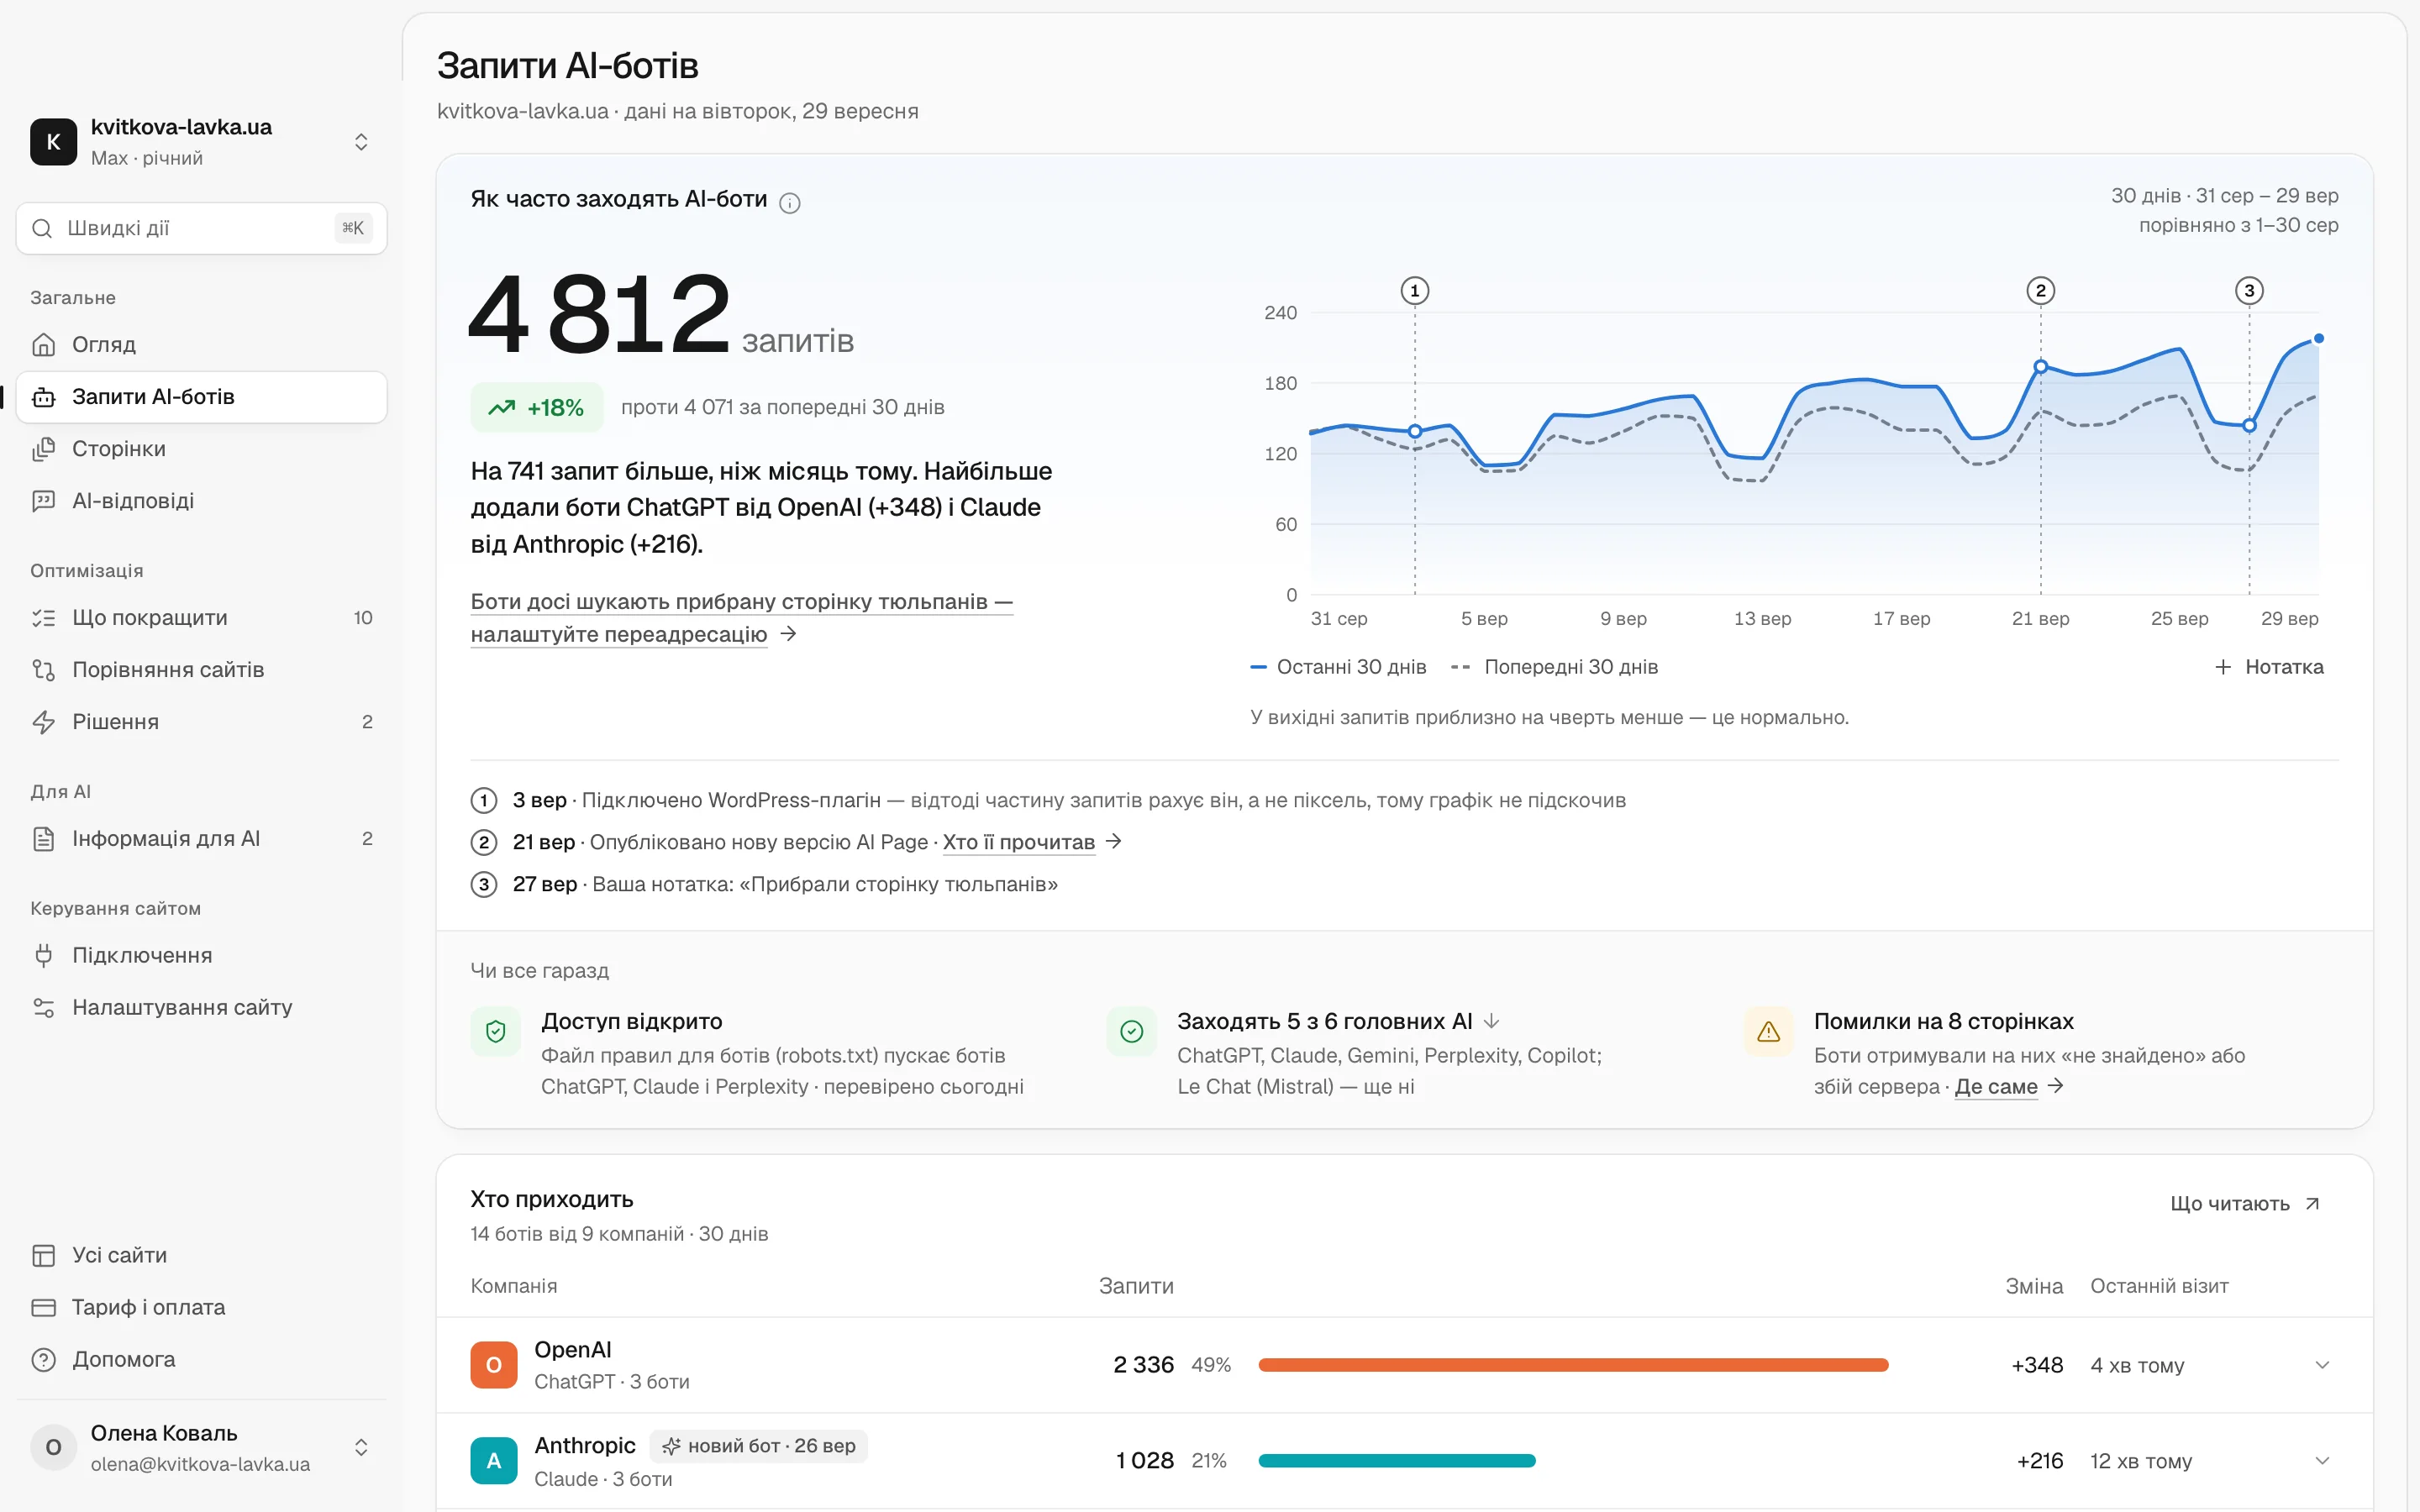
Якщо не хочеться розбирати логи вручну, Pulse показує, які AI-боти заходять на ваш сайт, що читають і де натрапляють на помилки. До кожної проблеми він підказує, що змінити.
Як перевірити, що «GPTBot» справді GPTBot
Скопіювати рядок user agent може будь-хто. Cloudflare повідомляв про незадекларованих краулерів, які маскувалися під звичайні браузери й змінювали IP. Тож назва бота в лозі — це заява, а не доказ.
- Списки IP. Звіряйте IP з JSON-файлами, які публікують OpenAI та Perplexity. Google теж публікує власні списки.
- Reverse DNS. Для Google виконайте зворотний запит за IP (наприклад,
host 66.249.66.1). Переконайтеся, що ім'я хоста закінчується на googlebot.com, google.com або googleusercontent.com. Потім зробіть прямий запит за цим ім'ям і перевірте, що він повертає той самий IP. - Немає опублікованого списку. Якщо оператор не публікує діапазонів IP, повністю перевірити його ботів не вийде. Позначайте такі рядки у звітах як «заявлені», а не «перевірені».
- Підробки. Рахуйте їх окремо, щоб вони не роздували ваші цифри. Якщо вони навантажують сервер, блокуйте їх на файрволі й перевірте, що правило не зачіпає справжніх ботів.
Що виправляти насамперед
- Помилки 5xx, таймаути та блокування файрволом, на які натрапляють перевірені AI-боти.
- 404 на тих URL, які боти справді запитують. Налаштуйте редирект на актуальну сторінку.
- Ланцюжки редиректів. Ведіть кожну стару адресу одразу на кінцеву.
- Сторінки, що віддають порожню HTML-оболонку. Ключові факти мають бути в HTML, який надсилає сервер, а не підвантажуватися скриптами пізніше.
- Правила robots.txt або налаштування ботів у CDN, які випадково блокують пошукових ботів чи фетчерів користувачів. Про robots.txt та інші сигнали йдеться в дослідженні Chetver про llms.txt та інші сигнали для AI-краулерів у 2026 році.
Такі технічні дрібниці рідко здаються терміновими. Проте саме вони непомітно позбавляють бізнес згадок у відповідях AI.
Де реферальним переходам усе ж місце у звітності
GA4 залишайте. Реферальні переходи — справжній результат, і вони показують, які візити з AI перетворюються на заявки. Просто вважайте їх фінальним результатом, а не всією воронкою.
Логи показують, що потрапляє на вхід: що AI читає. Відстеження згадок показує, що виходить: що AI каже. Як виміряти цю останню частину, пояснює дослідження Chetver про Share of Model. Маючи всі три джерела, ви можете внести одну зміну й виміряти її ефект, а не гадати.
Що я зробив би на вашому місці
- Цього тижня вивантажте логи доступу або логи CDN за тиждень і запустіть grep, наведений вище.
- Запишіть три числа: боти за сторінками, коди відповіді та як часто з'являються ChatGPT-User і Claude-User.
- Перевірте IP за найбільшими рядками «AI-ботів» і відкладіть підробки окремо.
- Виправляйте помилки в порядку, наведеному вище, починаючи з 5xx і блокувань на сторінках із цінами та послугами.
- За місяць зробіть такий самий знімок і порівняйте. Жоден із цих кроків не гарантує згадки. Вони лише прибирають видимі перешкоди — а це та частина, яку ви контролюєте.
Часті питання
Чи може GA4 відстежувати візити GPTBot або ClaudeBot?
Ні. GA4 залежить від JavaScript-тегу, який краулери зазвичай не виконують, а відомих ботів Google виключає з GA4 автоматично. GA4 показує лише людей, які перейшли з відповідей AI. Щоб побачити самих краулерів, використовуйте логи доступу сервера або логи CDN.
Microsoft Clarity відстежує AI-краулерів чи лише AI-агентів?
У Clarity два окремі дашборди. Agent Activity охоплює AI-агентів від OpenAI, Google та Anthropic, які керують справжнім браузером на вашому сайті. AI Bot Activity у розділі Dashboards → AI Visibility показує, як краулери отримують доступ до вашого контенту. Його налаштовують окремо в Settings → AI Visibility.
Якщо ChatGPT-User зайшов на сайт, це означає, що ChatGPT згадав мій бізнес?
Не обов'язково. ChatGPT-User завантажує сторінку, коли вона потрібна для запиту користувача, тож це найближчий сигнал у логах, що відповідь складають на основі вашого сайту. Щоб знати, чи ваш бізнес справді назвали, відстежуйте самі відповіді.
Чи виконують AI-краулери JavaScript?
За аналізом мережі Vercel за грудень 2024 року, великі AI-краулери завантажують JavaScript-файли, але не виконують їх. Контент, що з'являється лише після запуску скриптів у браузері, може бути для них невидимим. Розміщуйте ціни, послуги й контакти в HTML, який надсилає сервер.
Як зрозуміти, що запит від GPTBot підроблений?
Звірте IP запиту з опублікованим списком OpenAI у файлі gptbot.json. Для OAI-SearchBot і ChatGPT-User зробіть те саме з їхніми файлами. Якщо IP у списку немає, вважайте запит неперевіреним, хоч би що було написано в user agent. Якщо оператор не публікує списку IP, позначайте його рядки як заявлені, а не перевірені.