Щоб відстежувати згадки бренду в ChatGPT, Gemini, Perplexity і Claude, складіть 10–20 запитань так, як їх ставлять ваші клієнти. Кожне запитання поставте кілька разів у чистій сесії. Для кожного запуску записуйте, чи вас назвали, на якому місці, поряд із якими конкурентами і з яких джерел. Потім повторюйте той самий набір за тим самим графіком щомісяця і стежте за тенденцією, а не за окремою відповіддю.
Зараз саме час зафіксувати відправну точку. Google почав розгортати листопадове базове оновлення 2026 року і випустив оновлення Пошуку на основі Gemini 4 Hydrogen. Того ж тижня Seer Interactive опублікувала докладне повторне вимірювання власних згадок у ChatGPT, і її методику варто взяти за зразок. Нижче ми перетворюємо таку методику на щомісячну процедуру, для якої не потрібні спеціальні інструменти.
Чому одна перевірка в ChatGPT майже нічого не показує
ChatGPT, Gemini, Perplexity і Claude щоразу пишуть відповідь заново. Поставте те саме запитання двічі, і можете отримати інший перелік назв, в іншому порядку, з інших джерел. Якщо ви один раз ввели запитання і побачили свій бренд (або не побачили), у вас одна вибірка, а не вимірювання.
Цифри Seer Interactive показують, наскільки великим буває розкид. У лютому 2025 року Віл Рейнольдс (Wil Reynolds) поставив ChatGPT три промпти, кожен по одному разу. ChatGPT назвав 21 агенцію і жодного разу не назвав Seer. У листопаді 2026 року Seer поставила ті самі три промпти по 10 разів на трьох актуальних моделях ChatGPT з увімкненим вебпошуком: разом 90 запусків. Seer згадали в 58 із них, тобто приблизно в 64% (у заголовку це округлено до 65%).
Показники за окремими запитаннями важливіші за загальний. Seer з'явилася в 25 з 30 відповідей на промпт про «PPC і SEO-агенцію» і в 28 з 30 на промпт про «SEO-компанії, що працюють з даними», але лише в 5 з 30 на промпт про «інноваційну SEO-агенцію». Той самий бренд, той самий тиждень: від «майже завжди» до «зрідка» залежно від формулювання.
Seer також чесно перелічує обмеження свого порівняння. Базовий замір 2025 року — це один запуск у ChatGPT під обліковим записом на GPT-4o. Запуски 2026 року йшли через API без пам'яті й персоналізації, на новіших моделях. І зміну неможливо пов'язати пункт за пунктом із конкретними діями. Висновок для вас: зафіксуйте умови з першого дня і ставте кожне запитання більше ніж один раз.
Як відстежувати згадки бренду в ChatGPT: план у п'ять кроків
Процедура складається з п'яти кроків. Вам знадобляться таблиця, безкоштовні або платні версії чотирьох асистентів і фіксований час щомісяця.
- Складіть 10–20 тестових запитань так, як їх ставлять клієнти.
- Поставте кожне запитання кілька разів у чистій сесії в кожному асистенті.
- Запишіть кожен запуск в одну таблицю.
- Зведіть журнал до показника Share of Model.
- Повторюйте за фіксованим щомісячним графіком і занотовуйте зовнішні події.
Крок 1. Складіть 10–20 запитань так, як їх ставлять клієнти
Тестові запитання мають звучати як слова реальних покупців, а не як ваші рекламні тексти. Беріть формулювання з розмов відділу продажів, листів у підтримку, відгуків і запитів у Google Search Console. Охопіть п'ять типів:
| Тип запитання | Що перевіряє | Шаблон |
|---|---|---|
| Категорія | Чи входите ви до типової відповіді у своїй галузі | «Який [категорія] добрий для [задача]?» |
| Локальне | Чи з'являєтеся ви для свого міста чи регіону | «Найкращий [послуга] у [місто]» |
| Порівняння | Як вас описують поряд із конкурентом | «[Ви] чи [конкурент]: що краще для [потреба]?» |
| Альтернативи | Чи пропонують вас як варіант для переходу | «Альтернативи [конкурент]» |
| Від проблеми | Чи згадують вас, коли покупець описує потребу, а не категорію | «Як [розв'язати проблему] без [незручність]?» |
Умовний приклад: юридична фірма в Києві, що веде сімейні справи. Її набір може містити «найкращий адвокат з розлучень у Києві», «юридична фірма в Києві для справ про місце проживання дитини», «[Фірма] чи [фірма-конкурент]», «альтернативи [фірма-конкурент]» і «як розлучитися, якщо чоловік живе за кордоном». Більшість запитань не повинна містити назви вашого бренду, бо вони перевіряють, чи знайде вас асистент сам. Додайте два-три брендові запитання («Скільки коштує консультація в [Фірма]?») окремою групою. Вони перевіряють не те, чи вас знаходять, а те, чи правильні факти.
Дайте кожному запитанню ідентифікатор (Q01, Q02…) і більше не змінюйте формулювання. Якщо потрібне нове запитання, додайте його під новим ідентифікатором і починайте його історію з нуля.
Крок 2. Ставте кожне запитання кілька разів у чистій сесії
Ваша історія чатів, пам'ять і місцезнаходження можуть впливати на відповідь асистента. Чисті й однакові умови роблять цифри цього місяця порівнянними з наступним.
- Працюйте в чистій сесії. Вийдіть з облікового запису або відкрийте тимчасовий чи анонімний чат із вимкненими пам'яттю й персоналізацією, якщо асистент дає таку можливість.
- Для кожного запуску відкривайте новий чат. Вставляйте точне формулювання. Без уточнювальних запитань і без «а як щодо нас?».
- Де можна, залишайте вебпошук увімкненим і відмічайте, чи він спрацював. Seer тестувала з увімкненим вебпошуком, тож її цифри відображають відповіді, які могли спиратися на актуальні вебсторінки.
- Ставте кожне запитання 3–5 разів у кожному асистенті. Seer робила по 10 запусків на промпт для кожної моделі. Що більше запусків, то стабільніший показник, тож для справді важливих запитань збільшуйте кількість.
- Записуйте модель, дату й місцезнаходження. Фіксуйте назву моделі, якщо інтерфейс її показує, і країну, з якої тестували. Локальні відповіді залежать від місцезнаходження, тому не перемикайте VPN між місяцями.
Оберіть один спосіб і тримайтеся його: або звичайні застосунки, або API. API — це інтерфейс для розробників, який надсилає запитання моделі напряму, без пам'яті застосунку й налаштувань облікового запису. Застереження Seer показує, що відповіді із застосунків під обліковим записом і через API можуть відрізнятися, тож якщо змішувати ці способи, тенденція розмиється.
Крок 3. Записуйте кожен запуск в одну таблицю
Один рядок — один запуск. Цей шаблон охоплює все потрібне і для показників, і для подальшого аналізу прогалин:
| Стовпець | Що записувати | Приклад запису |
|---|---|---|
| Дата | День запуску | [РРРР-ММ-ДД] |
| Асистент і модель | Продукт і назва моделі, якщо її видно | ChatGPT, [модель] |
| ID запитання | Із вашого фіксованого списку | Q04 |
| № запуску | 1, 2, 3… | 2 |
| Згадано? | Так / Ні | Так |
| Позиція | Місце в переліку або «єдина згадка» | [3-тє з 6] |
| Згадані конкуренти | Усі інші бренди у відповіді | [Конкурент А], [Конкурент Б] |
| Процитовані джерела | URL, на які послався асистент | [URL добірки], [ваша головна сторінка] |
| Чи згадує вас джерело? | Так / Ні / Не перевірено | Ні |
| Реклама чи органіка | Позначайте будь-яке рекламне розміщення | Органіка |
| Факти правильні? | Ціни, адреса, послуги, графік роботи | Неправильний графік роботи |
Два стовпці потребують особливої уваги. Процитовані джерела: коли асистент показує джерела, копіюйте URL. Це головна підказка, коли згодом шукатимете прогалини. Реклама чи органіка: у ChatGPT тепер є реклама, і останнє оновлення ChatGPT Ads від OpenAI додало в Ads Manager інтелектуальне призначення ставок і нові цільові показники вартості. Ніколи не зараховуйте платне розміщення як органічну згадку.
Крок 4. Зведіть журнал до показника Share of Model
Share of Model — це частка відповідей AI, у яких названо ваш бренд: аналог частки голосу (share of voice) для AI. Підхід ми пояснюємо в дослідженні про вимірювання Share of Model і видимості в AI. Для щомісячного вимірювання достатньо таких показників:
- Частка згадок = запуски, де вас назвали ÷ усі запуски × 100.
- Частка згадок за асистентом: та сама формула окремо для ChatGPT, Gemini, Perplexity і Claude.
- Частка згадок за типом запитання: категорія, локальне, порівняння, альтернативи, від проблеми.
- Частка конкурента: та сама формула для кожного конкурента в журналі.
- Середня позиція — лише для запусків, де вас назвали.
Опубліковані цифри Seer годяться для розрахункового прикладу. Seer: 58 ÷ 90 = 64%. Її конкурент iPullRank з'явився в 50 з 90 відповідей, приблизно 56%. Проте на промпт про «інноваційну SEO-агенцію» iPullRank назвали в 23 з 30 запусків, а Seer — у 5 з 30. Сам лише загальний показник цю різницю приховав би.
Seer також розподіляє бренди за рівнями стабільності, і їх можна використати. Стабільно — названо щонайменше у 2 з 3 відповідей. Зрідка — менш ніж в 1 з 3. Іноді — усе між ними. З 21 агенції, яку ChatGPT назвав у лютому 2025 року, жодна, за даними Seer, не з'являлася стабільно в листопаді 2026-го: 4 — іноді, 8 — зрідка, 9 — жодного разу.
Крок 5. Повторюйте за фіксованим щомісячним графіком
- Проганяйте весь набір щомісяця в той самий тиждень і в тих самих умовах.
- Записуйте зовнішні події в стовпець «контекст» поряд із місяцем.
- Порівнюйте частку згадок за асистентами й типами запитань із попереднім місяцем.
- Оберіть одну-дві прогалини для роботи (див. наступний розділ) і записуйте дату кожної зміни на сайті чи в профілях.
- Наступного місяця повторіть замір і перевірте, чи зрушилися цільові запитання.
Для листопада 2026 року стовпець «контекст» уже має кілька записів. Search Engine Roundtable повідомив про коливання позицій 8 і 9 листопада та про початок розгортання базового оновлення. Google випустив оновлення Пошуку на Gemini 4 Hydrogen за кілька днів після виходу Gemini 4 Carbon. Також Google підтвердив помилку логування у звіті Search Console про ефективність у генеративному AI за 9–11 листопада, через яку покази були занижені. Якщо порівнюєте дані з боку Google, позначте ці дати як ненадійні. Фіксуйте й зміни моделей ChatGPT: моделі, які Seer тестувала у 2026 році, відрізнялися від тієї, що використовувалася у 2025-му.
Як читати прогалини в журналі
Показники кажуть, де ви зараз. Стовпці з джерелами й конкурентами пояснюють чому.
Вас не згадують узагалі
Відкрийте джерела, які асистенти процитували для цього запитання, і перевірте, чи згадують там вас. Аналіз Seer показує, на що дивитися. У 58 відповідях, де назвали Seer, ChatGPT процитував власний сайт Seer у 21 (головну сторінку і сторінки /work). Чотири інші найчастіше цитовані сторінки — добірки «найкращих агенцій» на сайтах агенцій, які ставлять себе на перше місце. Дві з них містили Seer, на 4-му і 3-му місцях, і всі чотири оновлювалися протягом останніх кількох місяців. Якщо сторінки, на які спирається відповідь, вас не згадують, асистентові просто нема з чим працювати.
Конкурентів називають із добірок і каталогів
Складіть список усіх сторонніх сторінок, де є конкуренти, але немає вас: сайти відгуків, галузеві каталоги, маркетплейси на кшталт Prom.ua чи Rozetka, статті «найкращі…», сторінки порівнянь. Це ваш список для контактів і розміщень. Просіть, щоб вас розглянули, оновлюйте застарілі профілі й стежте за точністю. Не намагайтеся штучно створювати згадки.
Вас згадують, але з помилками у фактах
Неправильні ціни, стара адреса чи послуги, яких уже немає, ведуть до вашого сайту і ваших профілів. Знайдіть, на якій процитованій сторінці лишився застарілий факт. Потім подбайте, щоб актуальні факти були на одній зрозумілій, легкій для читання сторінці.
Чи можуть AI-боти прочитати ваш сайт?
Якщо ваших сторінок ніколи немає серед джерел, насамперед перевірте доступ. Подивіться robots.txt, налаштування ботів у CDN і правила файрвола: чи не заблоковано там краулери на кшталт OAI-SearchBot (пошук ChatGPT), ClaudeBot (Anthropic) і PerplexityBot. Наша карта llms.txt та інших сигналів для AI-краулерів у 2026 році пояснює, як правила robots.txt поєднуються з іншими сигналами. Журнали сервера показують, чи ці боти справді приходять і на які помилки натрапляють. Pulse показує те саме в дашборді: які AI-боти заходять, що читають і де спотикаються.
Що змінює цифри: доступ ботів, сторінка з фактами і сторонні майданчики
Вимірювати і виправляти — різні завдання. Ширшу картину описано в нашому дослідженні про те, як правила видимості змінюються від SEO до GEO. GEO (generative engine optimization) — це робота над тим, щоб AI-асистентам було легко знайти, зрозуміти й процитувати ваш бізнес. Ось важелі, які найчастіше пояснюють прогалину в журналі:
| Важіль | Що перевірити | Де дивитися |
|---|---|---|
| Доступ ботів | Пошукові AI-краулери дозволені й не заблоковані правилами CDN чи файрвола | robots.txt, налаштування CDN, журнали сервера |
| Помилки на ключових сторінках | Боти отримують відповідь 200 на сторінках послуг, цін і контактів, а не 403 чи 5xx | Журнали сервера, звіти про ботів |
| Сторінка з фактами | Ціни, графік, контакти й послуги актуальні й зібрані в одному місці | Ваш сайт, AI Page, llms.txt |
| Ваші ключові сторінки | Головна, сторінки кейсів чи послуг чітко кажуть, що ви робите і для кого | Сторінки, які асистенти цитують про вас |
| Сторонні майданчики | Ви є в добірках, каталогах і на сайтах відгуків, які цитують асистенти | Стовпець «процитовані джерела» у журналі |
Для сторінки з фактами один із варіантів — AI Page від Chetver. Сервіс Chetver збирає з вашого сайту сторінку з цінами, графіком, контактами й послугами, ви публікуєте її на aipage.yoursite.com, і до неї додається файл llms.txt. Докладніше ідею пояснює наше дослідження про GEO, AIEO і те, навіщо бізнесу AI Page. Хоч би що ви змінювали, записуйте дату, щоб цифри наступного місяця можна було читати з урахуванням зміни.
Реальний замір «до» і «після»: Sereda.ai
Кейс Sereda.ai показує фіксовану методику з чіткими датами. Sereda.ai — українська HR-платформа. До появи AI Page ChatGPT казав, що не знає цього продукту, а в переліках HR-інструментів його майже не було. AI Page опублікували 22 жовтня 2025 року.
- Запитань: 4.
- Оцінювання: 5 критеріїв × 10 балів, приведено до шкали 100 і усереднено за 4 запитаннями. Двоє дослідників оцінювали відповіді незалежно.
- «До»: вересень — початок жовтня 2025 року. «Після»: початок грудня 2025 року.
- Результат: ChatGPT 24 → 87, Gemini 28 → 91.
У кейсі кожну відповідь оцінюють за п'ятьма критеріями, а не рахують згадки, тож це інший показник, ніж Share of Model. Але структура саме та, що потрібна вашому вимірюванню: фіксовані запитання, фіксований спосіб оцінювання, датована зміна і періоди заміру до і після неї. Це один кейс, а не прогноз для будь-якого іншого бізнесу.
Коли варто автоматизувати вимірювання
Ручне вимірювання нічого не коштує, крім часу. 15 запитань, чотири асистенти, по три запуски — це 180 запусків на місяць, які треба ввести й записати. Ми радимо перший місяць-два робити все вручну, щоб зрозуміти, які запитання і джерела важливі. Після цього автоматизація заощадить час.
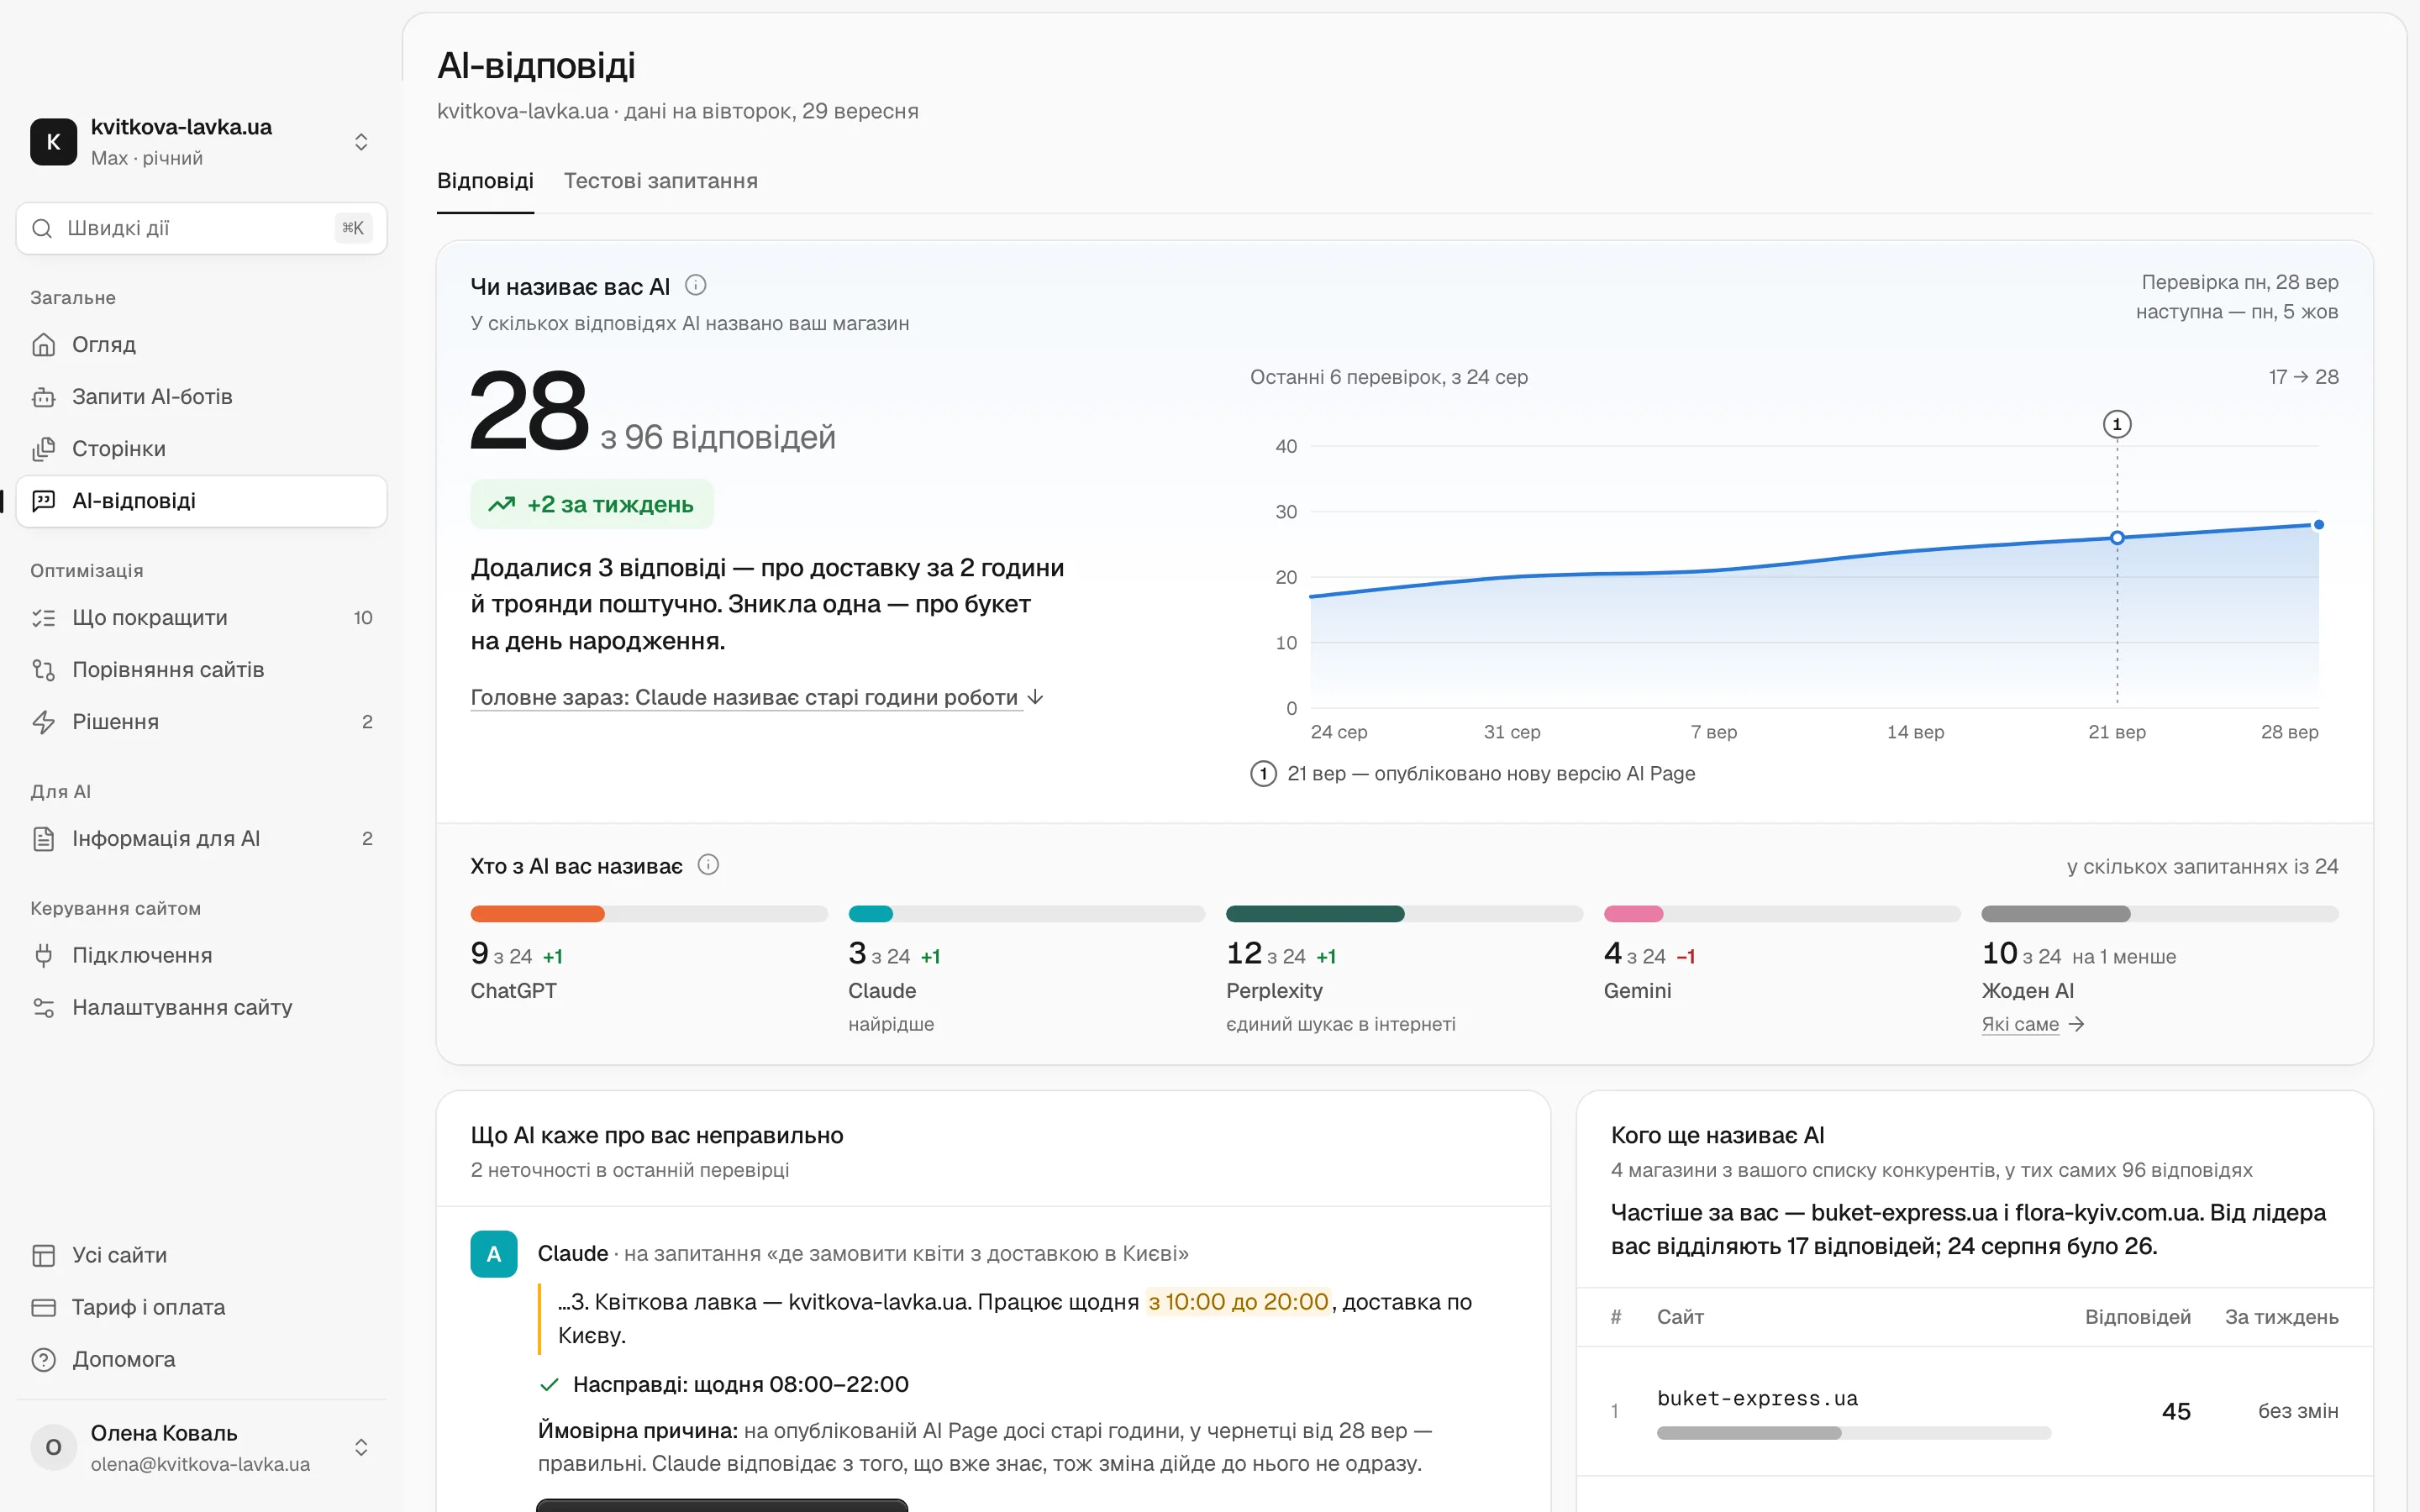
Для першого погляду безкоштовна AI-перевірка показує, як AI бачить ваш бізнес і що зробити, щоб він називав вас, а не когось іншого. Для регулярного виміру функція «AI-відповіді» на тарифі Max ($99 на сайт на місяць, див. тарифи) щотижня ставить ChatGPT, Claude, Perplexity і Gemini ваші тестові запитання і рахує, скільки відповідей вас згадують. Basic і Pro охоплюють бік сайту: щотижневі перевірки й оцінку готовності до AI, а на Pro — ще й те, які AI-боти читають які сторінки і де натрапляють на помилки.
Відстежуйте бізнес-результати поряд зі згадками, бо видимість — це ще не виторг. Seer повідомляє, що з листопада 2024 року до 22 жовтня 2026 року AI-асистенти принесли їй 0,3% сесій і 0,2% підписок на розсилку: 2 359 сесій і 9 підписок. Додайте переходи з AI до свого звіту в аналітиці. З боку Google допоможе нова довідка Google про те, як розпізнавати трафік із Google Пошуку за HTTP-заголовком Referer, згадана в тому ж огляді: з нею цей трафік легше відокремити.
Ваш наступний крок
Регулярне вимірювання корисне лише тоді, коли запитання й умови не змінюються від місяця до місяця. Цього тижня складіть 10–20 запитань з ідентифікаторами, підготуйте шаблон журналу з цієї статті і зробіть перший базовий замір до кінця листопада. Позначте в стовпці «контекст» базове оновлення, запуск Gemini 4 Hydrogen і помилку Search Console за 9–11 листопада. Наступного місяця проженіть той самий набір ще раз і проаналізуйте прогалини з огляду на джерела, які процитував кожен асистент.
Часті питання
Чи ChatGPT відповідає всім однаково про мій бренд?
Ні. Кожну відповідь модель генерує заново, тож на те саме запитання від запуску до запуску можуть називатися різні бренди. На відповідь також впливають пам'ять, історія чатів і місцезнаходження. Тому тестуйте в чистій сесії і ставте кожне запитання кілька разів.
Скільки разів ставити одне запитання, щоб виміряти згадки в AI?
Почніть із 3–5 запусків на запитання в кожному асистенті, а для найважливіших запитань робіть більше. Seer Interactive у своєму вимірюванні в листопаді 2026 року робила по 10 запусків на промпт для кожної моделі. Що більше запусків, то стабільніша частка згадок.
Чи покаже Google Search Console згадки мого бренду у відповідях AI?
Лише з боку Google. У Search Console є звіт про ефективність у генеративному AI для AI-функцій Google Пошуку. ChatGPT, Claude і Perplexity він не охоплює. Google підтвердив помилку логування в цьому звіті за 9–11 листопада 2026 року, через яку покази були занижені, тож позначте ці дати як ненадійні.
Чи рахувати рекламу в ChatGPT як згадку бренду?
Не в межах відстеження органічних згадок. У ChatGPT тепер є реклама з налаштуваннями ставок в Ads Manager, тож позначайте будь-яке рекламне розміщення в окремому стовпці. Не включайте його в показник Share of Model.
Чи можна безкоштовно відстежувати згадки бренду в ChatGPT?
Так. Фіксований набір тестових запитань, чисті сесії і журнал у таблиці коштують лише часу. Безкоштовна AI-перевірка від Chetver дає перше уявлення про те, як AI бачить ваш бізнес, а тариф Max автоматизує щотижневі тестові запитання в ChatGPT, Claude, Perplexity і Gemini.