Помогает ли микроразметка Schema.org в ИИ-поиске? Помогает, но меньше, чем обещает большинство советов. Разметка помогает поисковым системам прочитать факты о вашем бизнесе и даёт расширенные сниппеты в Google. Но нет данных, что она сама по себе приводит к цитированию страницы в ChatGPT. В новом исследовании Университета Торонто страницы сравнивали внутри одного сайта и не нашли значимого эффекта ни от разметки, ни от блоков FAQ, ни от кратких выжимок. Гораздо важнее оказался поиск (retrieval) — то, какие страницы вообще находит собственный поиск ИИ.
Отсюда простой порядок работы. Сначала убедитесь, что ИИ-поиск может найти и прочитать ваши страницы. Потом следите, чтобы разметка была точной. Ниже — данные, на которых основан этот совет, и чек-лист того, что исправить в первую очередь.
Помогает ли микроразметка в ИИ-поиске: что говорят данные о цитированиях
Микроразметка — это код в HTML страницы, который описывает факты вроде названия, адреса или цен в общем словаре schema.org. Обычно её пишут в формате JSON-LD — небольшом блоке структурированного текста, которого посетители не видят. Многие руководства утверждают, что разметка помогает ИИ «понять» сайт. Немногие из них приводят данные, которые позволяют это утверждение честно проверить.
Исследование: 158 099 ответов ИИ из двух рынков
10 октября 2026 года Махе Чэнь (Mahe Chen) и Ник Кудас (Nick Koudas) из Университета Торонто опубликовали работу «What Drives AI Citations? Content, Retrieval and Model Knowledge in Generative Engine Optimization (GEO)» (arXiv 2610.15033). Они изучили две 90-дневные выборки ответов на коммерческие вопросы: всего 158 099 ответов и 468 037 цитирований.
- Основной набор данных: домашний интернет в США. 651 вопрос, составленный для американского оптоволоконного провайдера, 143 249 ответов, 396 188 цитирований. Данные собирали ежедневно с 24 июня по 21 сентября 2026 года.
- Второй набор данных: небольшие поставщики программ для бизнеса. 55 вопросов, 14 850 ответов, 71 849 цитирований.
Ответы получали через публичные API с включённым веб-поиском: ChatGPT (GPT-5.4 nano с веб-поиском), Gemini (Gemini 3.1 Flash Lite с опорой на Google Search) и Perplexity (Sonar). «Разметкой schema.org» в исследовании считается любой тип в JSON-LD или microdata. «Краткая выжимка» — вводный фрагмент вроде TL;DR, «главное» или быстрого ответа.
Если сравнивать разные сайты, работает всё
Когда авторы сравнивали разные сайты между собой, все популярные рекомендации выглядели полезными, и все результаты были статистически значимыми. Страницы с блоком FAQ получали на 18,1% больше цитирований. Краткие выжимки сопровождались ростом на 20,9%, блоки об авторе — на 14,9%, микроразметка — на 7,5%. Страница, которая загружалась быстрее на одно стандартное отклонение, получала на 11,7% больше цитирований.
Многие заявления в духе «разметка повышает видимость в ИИ» опираются как раз на такие межсайтовые сравнения. Следующее сравнение показывает, почему они могут вводить в заблуждение.
Внутри одного сайта ни один фактор не значим
Затем авторы сравнили страницы внутри одного сайта. Так убирается всё, чем сайты отличаются друг от друга: сила бренда, возраст домена, известность компании. После этого ни одна из практик не показала значимого эффекта.
| Элемент страницы | Между сайтами | Внутри одного сайта |
|---|---|---|
| Блок FAQ | +18,1% (значимо) | −3,4% (незначимо) |
| Краткая выжимка | +20,9% (значимо) | +6,9% (незначимо) |
| Блок об авторе | +14,9% (значимо) | −4,6% (незначимо) |
| Разметка schema.org | +7,5% (значимо) | −5,3% (незначимо) |
| Скорость страницы (+1 SD) | +11,7% (значимо) | −1,1% (незначимо) |
Авторы объясняют это парадоксом Симпсона: тенденция, заметная при сравнении групп, исчезает или меняет знак внутри каждой группы. Сайты, которые часто цитируют по другим причинам, заодно чаще используют эти практики. Блоки FAQ есть на 43% страниц в четверти самых цитируемых сайтов и на 23% — в четверти наименее цитируемых. То есть, судя по данным, цитирования приносит не блок FAQ. Он просто чаще встречается на сайтах, которые и так цитируют.
«Незначимо» не значит «ноль». Это значит, что по данным эффект нельзя отличить от шума. Но до вывода «добавьте разметку, и вас будут цитировать» отсюда очень далеко.
Что это исследование может и не может сказать
Ограничения авторы перечисляют сами. Держите их в голове:
- Связи, а не причины. Исследование фиксирует закономерности. Разметку не добавляли и не убирали, чтобы измерить результат.
- API и небольшие модели, а не потребительские приложения. Приложение ChatGPT, которым вы пользуетесь, может вести себя иначе, чем GPT-5.4 nano через API. Ответы Perplexity воспроизвести не удалось вовсе.
- Вопросы на английском о рынке США. Вопросы составляли для организаций, которые пользуются мониторинговой платформой авторов, а не брали из реальных запросов пользователей.
- Примерно треть процитированных адресов проанализировать не удалось. Из 39 059 процитированных URL в основном наборе только 63,2% вернули пригодный HTML.
- Поддержка с данными. Ответы собирала мониторинговая платформа, которой управляют авторы, а в благодарностях упомянута команда ktau.ai за помощь с данными.
Почему решает поиск, а не разметка
Если свойства страницы объясняют так мало, что объясняет больше? Ответ исследования — поиск.
Все страницы, которые процитировал ChatGPT, нашёл его собственный поиск
Для каждого ответа ChatGPT переформулирует вопрос в собственные подзапросы и прогоняет их через свой поиск. Это называется query fan-out: один вопрос превращается в несколько поисков. В исследовании каждая страница, которую процитировал ChatGPT, была найдена его собственным поиском. То, какие страницы вернул этот поиск, объясняло 32% разброса цитирований между страницами одного сайта. Все свойства страниц вместе — 2,8%. Обе цифры относятся к ChatGPT, а не ко всем системам.
При одинаковой позиции в поиске микроразметка (×0,92), блоки FAQ (×0,93) и блоки об авторе (×0,77) сопровождались чуть меньшими шансами на цитирование. Страницы брендов — большими (×1,71). Одна только позиция объясняла 26,8% того, какой результат выбирался. Добавление всех признаков совпадения и свойств страницы подняло эту долю лишь до 32,5%.
У ИИ-систем ещё и собственное ранжирование. Их подзапросы редко совпадают с выдачей Google или Bing, а цитируют они в основном верх своего списка. Хорошие позиции в Google не гарантируют, что вы окажетесь там же.
Что действительно важно: страницы, которые отвечают на вопрос
Эффект содержания, который сохранился внутри сайтов, — релевантность. Когда лучший абзац страницы соответствовал вопросу на одно стандартное отклонение лучше, страница получала на 15,5% больше цитирований (95% ДИ 11,1–20,1%). Совпадение заголовка добавляло 14,1%, совпадение слов — 9,1%. Для одного только ChatGPT совпадение заголовка эффекта не дало (−0,2%): ChatGPT ищет по своим переформулированным запросам, а не по формулировке пользователя.
Количество упомянутых на странице цен или мест на результат не влияло. Страницы, где упоминалось больше отслеживаемых брендов, получали на 11,8% больше цитирований на одно стандартное отклонение. Такая закономерность выгодна страницам-сравнениям и подборкам.
Бренды, которые модель уже знает, ищут чаще
Важно и то, что модель знает заранее. ChatGPT вписывал бренд в поисковые подзапросы в 67% случаев, если бренд был в её исходных знаниях, и в 11% — если не был. В 46% случаев, когда ChatGPT упоминал бренд, не названный пользователем, ни одна процитированная страница это упоминание не подтверждала. Разметка на ваших страницах этого не меняет: исходные знания модели складываются из того, что она узнала о бренде ещё до поиска.
ChatGPT ищет на вашем же сайте «официальные» данные и цены
Второе исследование показывает, куда уходят эти подзапросы. Ahrefs проанализировали 66,6 млн ответов бесплатного ChatGPT без входа в аккаунт (модель GPT-5.6 Luna) за август и сентябрь 2026 года во всех странах, а также 15 млн подзапросов за ними. Подзапросы были в 14,4% ответов — в среднем около 1,6 на такой ответ.
- 6,8% подзапросов использовали оператор
site:, который ограничивает поиск одним доменом. Они затронули около 116 000 доменов. - Среди примерно 160 доменов, по которым чаще всего искали через
site:, 75,9% таких поисков приходились на сайты брендов, 11,9% — на ритейлеров, 1,9% — на Reddit и Facebook вместе. - В англоязычных подзапросах доля слова «official» (официальный) выросла с 10,1% в августе до 13,1% в сентябре, а «price» (цена) — с 6,0% до 8,9%. После «2026» это были самые частые слова.
Ahrefs делают вывод, что ChatGPT всё чаще идёт к владельцу информации — например, к бренду, который устанавливает цену. И предупреждают, что со следующим обновлением модели это может измениться. Практический вывод: ChatGPT может искать ваши цены и официальные данные на вашем собственном сайте. Если этих фактов нет ни на одной доступной для обхода странице, он их там не найдёт.
Какие типы микроразметки всё же стоит добавить
Всё это не делает разметку бесполезной. Просто это неподходящий инструмент, чтобы попасть в цитаты. Две полезные задачи она по-прежнему решает.
Расширенные сниппеты и товарные карточки в Google. Разметка Product и Offer передаёт цену и наличие в торговые функции Google. Что касается именно ИИ-функций, в документации Google об ИИ-функциях сказано: чтобы появляться в AI Overviews или AI Mode, не нужны дополнительные требования или особая оптимизация сверх обычного права на показ в Поиске.
Чёткие факты о компании. Google описывает разметку Organization как способ помочь ему понять название, логотип, адрес, контакты и официальные профили компании. Правила Google для структурированных данных требуют, чтобы разметка описывала видимое основное содержимое. Разметка скрытого содержимого может лишить страницу расширенных результатов.
| Тип разметки | Что даёт | Чего не даёт для ИИ | Вывод |
|---|---|---|---|
| Organization | Название, логотип, адрес, контакты и профили sameAs в одном согласованном месте | Не помогает страницам попасть в поиск ИИ и в цитаты | Добавьте на главную или страницу «О компании» |
| LocalBusiness | Часы работы, адрес и телефон для локального поиска | Не заменяет видимую страницу контактов, которую может найти ИИ-поиск | Добавьте, если принимаете клиентов по адресу |
| Product / Offer | Цена, наличие и товарные карточки в Google | Доказанного влияния на цитирование в ChatGPT нет; в исследовании из Торонто количество цен на странице ни на что не влияло | Добавьте для интернет-магазина; держите цены актуальными |
| FAQPage | Помечает блоки «вопрос — ответ» | Внутри сайтов незначимо (−3,4%); в 2023 году Google ограничил расширенные результаты FAQ известными государственными и медицинскими сайтами | По желанию; сначала напишите хорошие ответы |
| HowTo | Помечает пошаговые инструкции | Google отказался от расширенных результатов HowTo в 2023 году | Низкий приоритет |
Что исправить до того, как добавлять разметку
Пройдите эти четыре шага по порядку. Каждый важнее разметки, потому что от него зависит, доберётся ли ИИ-поиск до ваших фактов вообще.
- Проверьте, каких ИИ-ботов пускает ваш robots.txt.
- Отдавайте ключевой текст в HTML, сформированном на сервере.
- Перестаньте отдавать ИИ-краулерам ошибки и блокировки.
- Опубликуйте доступные для обхода страницы, которые отвечают на запросы об «официальных» данных и ценах.
1. Проверьте, каких ИИ-ботов пускает robots.txt
У каждой ИИ-компании есть отдельные боты для поиска, для запросов пользователей и для обучения, и управлять ими можно по отдельности.
| Бот | Компания | Что делает | Рекомендация |
|---|---|---|---|
| OAI-SearchBot | OpenAI | Показывает сайты в поиске ChatGPT; закрытые для него сайты не попадают в поисковые ответы, хотя могут появляться как навигационные ссылки | Разрешить |
| ChatGPT-User | OpenAI | Загружает страницы, когда об этом просит пользователь ChatGPT; robots.txt может не действовать на такие запросы | Разрешить и не блокировать в файрволе |
| GPTBot | OpenAI | Обучение | На ваше усмотрение |
| Claude-SearchBot | Anthropic | Улучшает результаты поиска Claude | Разрешить |
| Claude-User | Anthropic | Загружает страницы по запросу пользователя Claude | Разрешить |
| ClaudeBot | Anthropic | Обучение | На ваше усмотрение |
| PerplexityBot | Perplexity | Находит сайты и ставит на них ссылки в Perplexity; не используется для обучения базовых моделей | Разрешить |
| Perplexity-User | Perplexity | Загрузки по запросу пользователя; как правило, игнорирует robots.txt | Проверьте, что файрвол или защита от ботов его не блокирует |
| Googlebot | Поиск, включая AI Overviews и AI Mode | Разрешить |
Источники: OpenAI, Anthropic, Perplexity. Минимальный фрагмент robots.txt, который оставляет открытыми поисковых и пользовательских ботов, выглядит так:
User-agent: OAI-SearchBotAllow: /User-agent: ChatGPT-UserAllow: /User-agent: Claude-SearchBotAllow: /User-agent: Claude-UserAllow: /User-agent: PerplexityBotAllow: /
Одна оговорка из исследования Торонто: robots.txt — не идеальный выключатель. 7,1% страниц, которые цитировал ChatGPT, закрывали доступ OAI-SearchBot, а 19,9% страниц, которые цитировал Gemini, закрывали доступ Googlebot. Разрешение даёт ботам читать актуальную версию сайта, но не обеспечивает цитирование. Про llms.txt и другие сигналы для ИИ-краулеров читайте в нашем исследовании llms.txt и другие сигналы для ИИ-краулеров в 2026 году.
2. Отдавайте ключевой текст в HTML с сервера
HTML с сервера (серверный рендеринг) означает, что текст уже есть в HTML, который отправляет сервер, а не добавляется потом JavaScript-ом в браузере. Vercel и MERJ выяснили, что крупные ИИ-краулеры, включая GPTBot и ClaudeBot, скачивали JavaScript-файлы, но не выполняли их. В исследовании Торонто 11,5% загруженных страниц требовали JavaScript для показа основного текста. Внутри сайтов Gemini цитировал такие страницы значимо реже (−10,6%). Снижение для ChatGPT (−6,8%) и Perplexity (−2,1%) было незначимым.
Чтобы проверить страницу, откройте в браузере «Просмотр кода страницы» или загрузите её через curl и найдите свои цены и номер телефона. Если в исходном HTML их нет, бот, который не выполняет JavaScript, их не увидит.
3. Перестаньте отдавать ИИ-краулерам ошибки и блокировки
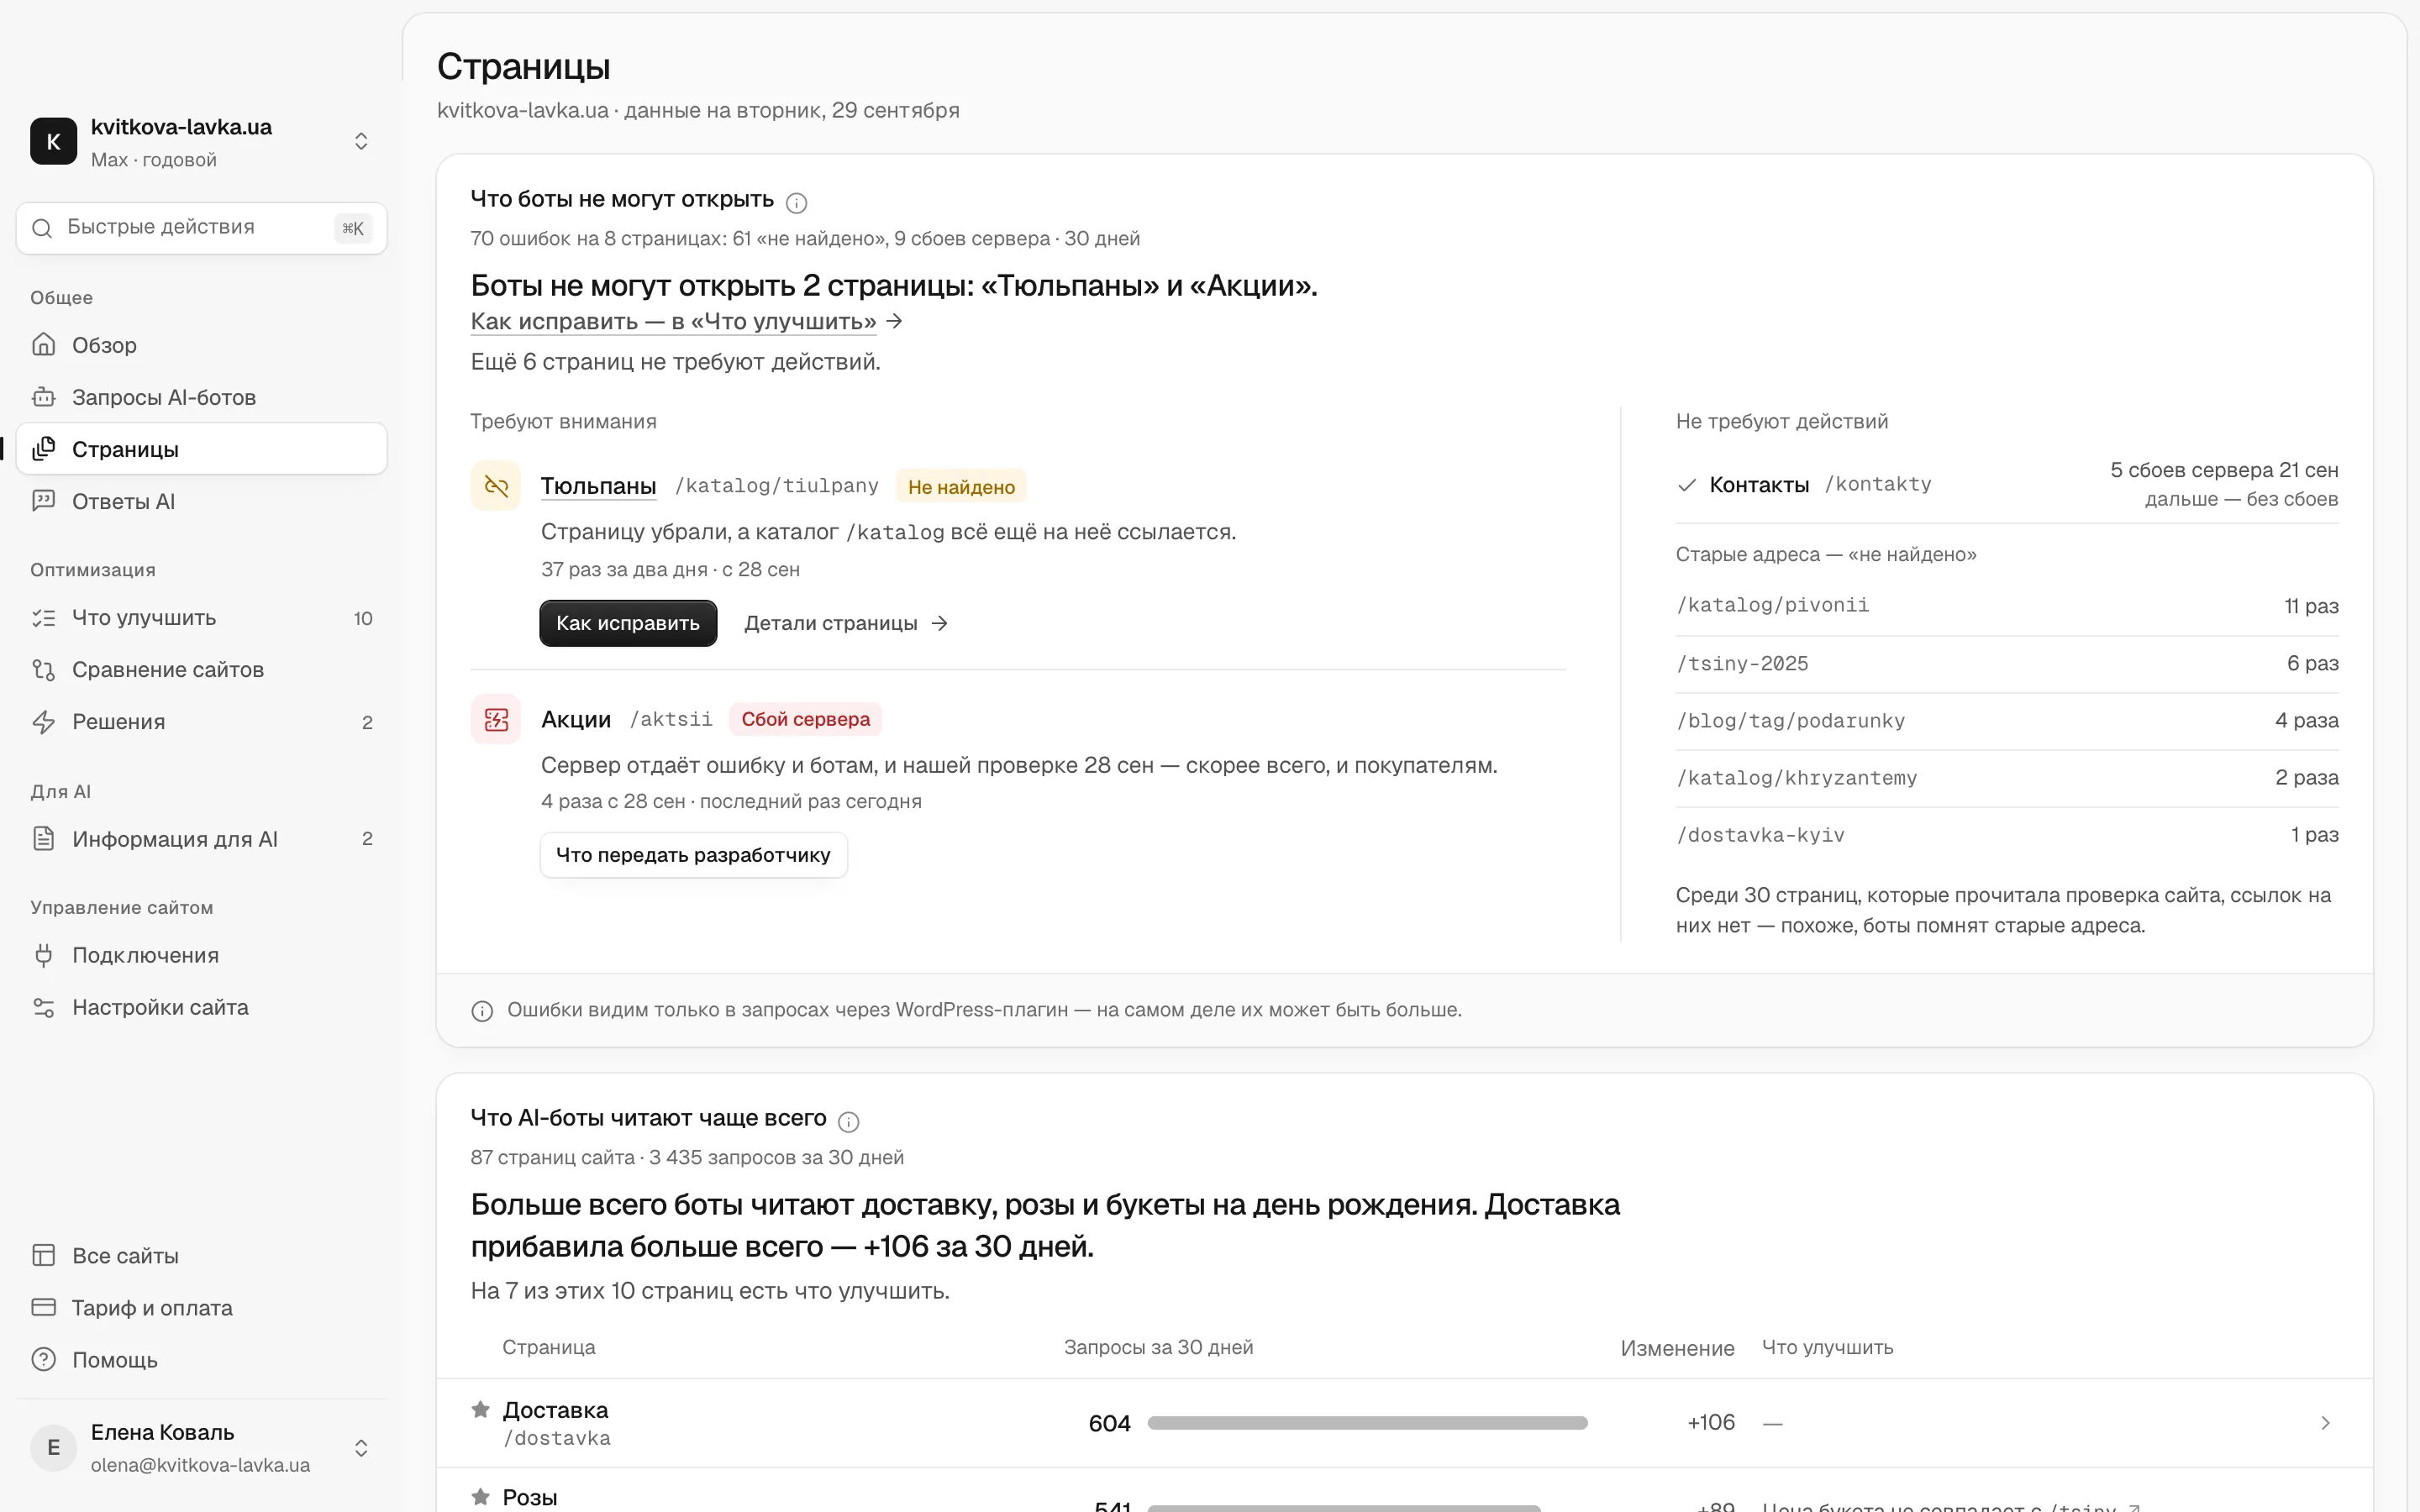
Файрволы, защита от ботов и ограничения частоты запросов могут отвечать ИИ-ботам кодом 403 Forbidden или серверными ошибками 5xx — и этого никто не заметит. Блокировки встречаются часто: среди страниц, которые системы всё-таки процитировали, 18,9% закрывали доступ краулеру исследователей в robots.txt, а 7,3% отказывали ему с кодом HTTP 403. Найдите в логах сервера имена ботов из таблицы выше и посмотрите, какие коды ответа они получают. Pulse показывает, какие боты ChatGPT, Claude, Gemini и других сервисов заходят на ваш сайт, что читают и где натыкаются на ошибки, и к каждой проблеме даёт совет, что изменить.
4. Опубликуйте страницы, которые отвечают на запросы об «официальных» данных и ценах
ChatGPT выполняет поиск с site:, чтобы найти официальные данные и цены. Поэтому на сайте должны быть простые, доступные для обхода страницы с ценами, контактами, часами работы и услугами. Данные из Торонто говорят, что больше упоминаний цен не помогает. Помогает страница, заголовок и абзацы которой прямо отвечают на вопрос, который будут искать.
Условный пример: стоматология в Алматы, у которой прайс в тенге есть только в PDF, а часы работы — только на картинке и в карточке 2GIS. Поиск вроде «[название клиники] официальный прайс» не находит на её сайте ничего, что можно извлечь. Одна HTML-страница с прайсом, часами работы и адресом в виде текста решает эту проблему. AI Page от Chetver собирает такие факты на одной странице: сервис Chetver строит её по вашему сайту — с ценами, часами работы, контактами и услугами, — вы публикуете её на aipage.вашсайт.kz (aipage.yoursite.com), и к ней прилагается файл llms.txt.
Как проверить, доходит ли ИИ-поиск до ваших фактов
Увидеть сам момент цитирования нельзя, но можно проверить каждое звено цепочки:
- Доступ: прочитайте свой robots.txt и сравните с таблицей ботов.
- Визиты: найдите в логах сервера OAI-SearchBot, ChatGPT-User, Claude-User и PerplexityBot и запишите, какие коды ответа они получают.
- Читаемость: убедитесь, что ключевые факты есть в исходном HTML.
- Разметка: прогоните её через валидатор и проверьте, что каждое значение совпадает с тем, что видят посетители.
- Ответы: каждую неделю задавайте ChatGPT, Claude, Perplexity и Gemini одни и те же несколько вопросов о вашем бизнесе. Отмечайте, упоминают ли вас и верны ли факты.
Часть этих проверок закрывает Chetver: Pulse — визиты ботов и ошибки, а на тарифе Max — еженедельный подсчёт того, сколько ответов ChatGPT, Claude, Perplexity и Gemini на ваши тестовые вопросы упоминают вас. Тарифы и их состав — на странице с ценами. Ни один инструмент и ни одно действие не гарантируют, что ИИ-ассистент вас процитирует. Эти проверки показывают, не мешает ли что-то с вашей стороны.
Итог: сначала поиск, потом разметка
Микроразметку стоит оставить ради расширенных сниппетов в Google и чётких, согласованных фактов о бизнесе. Но лучшие доступные сегодня данные не подтверждают, что она помогает попасть в цитаты ChatGPT. Важнее поиск и релевантность: может ли ИИ-поиск добраться до ваших страниц, прочитать их без JavaScript и найти страницу, которая отвечает на тот вопрос, который он на самом деле искал. О том, как меняются правила видимости, читайте в нашем исследовании от SEO к GEO.
Следующий шаг: пройдите бесплатную проверку в ИИ — она покажет, как ИИ-ассистенты видят ваш бизнес сейчас и что исправить в первую очередь.
Частые вопросы
Видит ли ChatGPT микроразметку JSON-LD на моей странице?
JSON-LD — это текст внутри HTML, поэтому его получает любой бот, который скачивает страницу. Мы не нашли документации OpenAI, где объяснялось бы, использует ли его поиск ChatGPT и как именно. В исследовании Университета Торонто при сравнении страниц одного сайта разметка не дала значимого эффекта на цитирование. Дублируйте ключевые факты видимым текстом.
Есть ли смысл добавлять разметку FAQ в 2026 году?
Только как задачу с низким приоритетом. В 2023 году Google оставил расширенные результаты FAQ только известным государственным и медицинским сайтам. В исследовании из Торонто блоки FAQ при сравнении разных сайтов сопровождались ростом цитирований на 18,1%, а внутри одного сайта — −3,4% (незначимо). Понятные ответы на странице важнее разметки вокруг них.
Помогает ли микроразметка попасть в AI Overviews и AI Mode от Google?
В документации Google сказано, что для AI Overviews и AI Mode нет дополнительных требований или особой оптимизации сверх обычного права на показ в Поиске. Разметка по-прежнему помогает с обычными расширенными сниппетами и товарными карточками, если она совпадает с видимым содержимым страницы.
Может ли llms.txt заменить микроразметку?
Нет, у них разные задачи. Разметка описывает факты на конкретной странице для поисковых систем. llms.txt — файл, который указывает ИИ-инструментам на ваш ключевой контент. Ни то, ни другое не заменяет доступные для обхода HTML-страницы, которые может найти ИИ-поиск.
Можно ли закрыть GPTBot, но оставить открытым OAI-SearchBot?
Можно. OpenAI позволяет управлять ими в robots.txt по отдельности. GPTBot используется для обучения. OAI-SearchBot определяет, может ли ваш сайт появляться в поисковых ответах ChatGPT. Если хотите, чтобы вас находили в ChatGPT, оставьте открытыми OAI-SearchBot и ChatGPT-User, что бы вы ни решили насчёт обучения. И проверьте, что их не блокирует файрвол.